LLMON、専用トークンで指示と参照データを分離 ↗
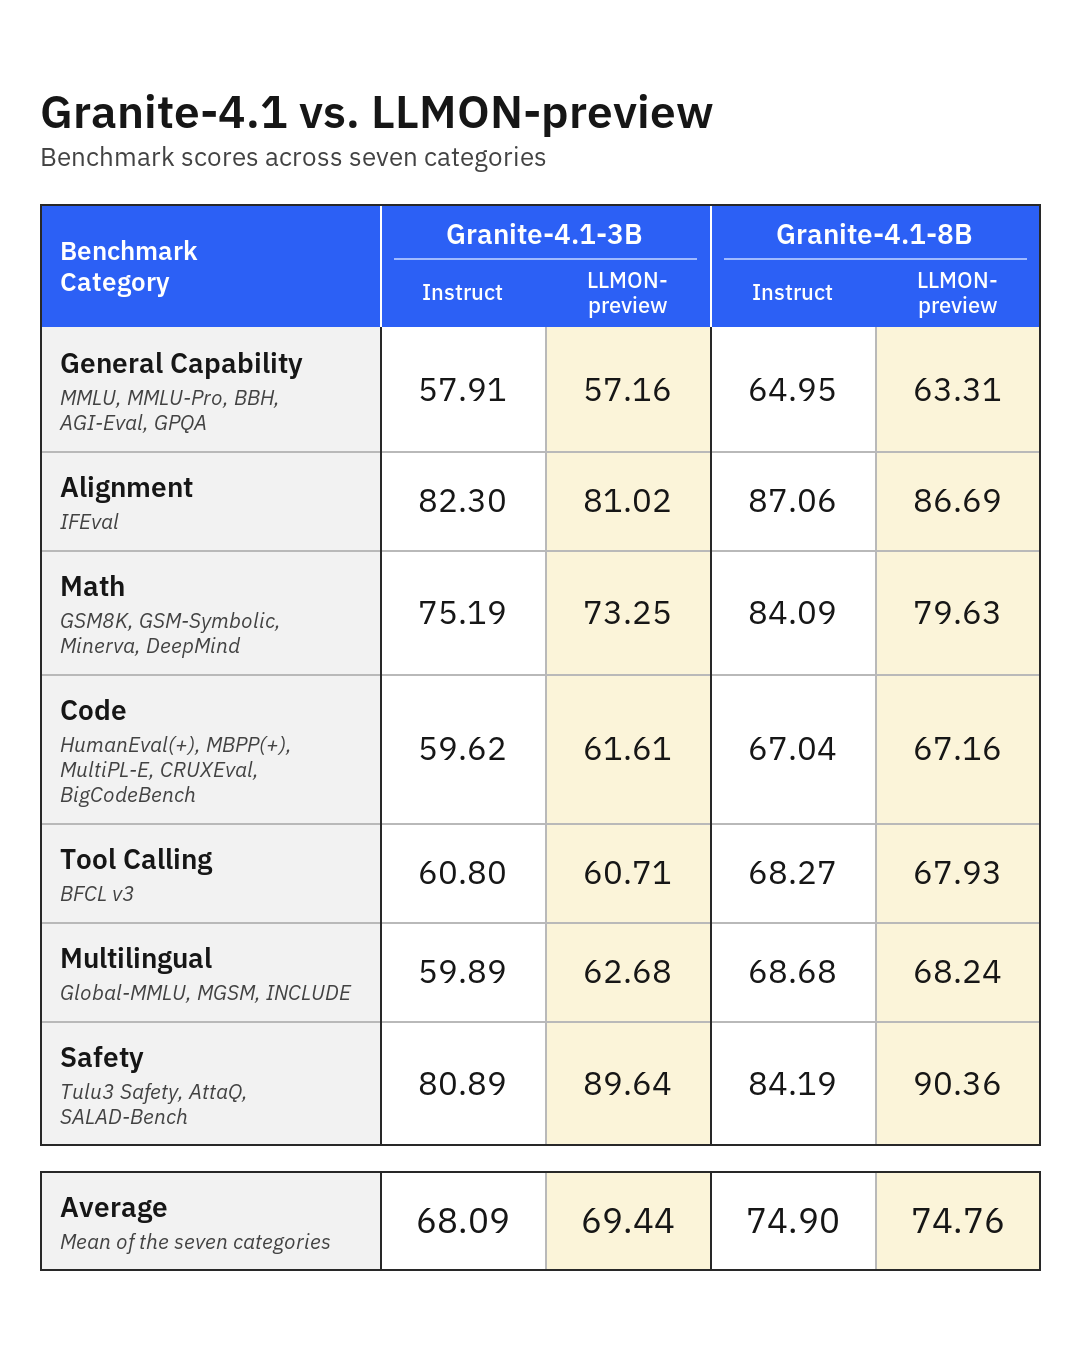
LLMON対応Graniteは、指示と参照データを区別して扱う実験的なLLM。専用トークンとIDで文章の各部分を区切り、どの指示をどのデータに適用するかを明示する。IBMの静的な間接攻撃9,000件のOPI評価では、攻撃に従わない割合がGPT-6 Astraより約47ポイント高かった。分離は学習された挙動であり、強制的な隔離保証ではない。3B・8Bの重みと変換ツールが公開されている。
原文を確認できた3件のAI技術ニュースを紹介。
LLMON対応Graniteは、指示と参照データを区別して扱う実験的なLLM。専用トークンとIDで文章の各部分を区切り、どの指示をどのデータに適用するかを明示する。IBMの静的な間接攻撃9,000件のOPI評価では、攻撃に従わない割合がGPT-6 Astraより約47ポイント高かった。分離は学習された挙動であり、強制的な隔離保証ではない。3B・8Bの重みと変換ツールが公開されている。
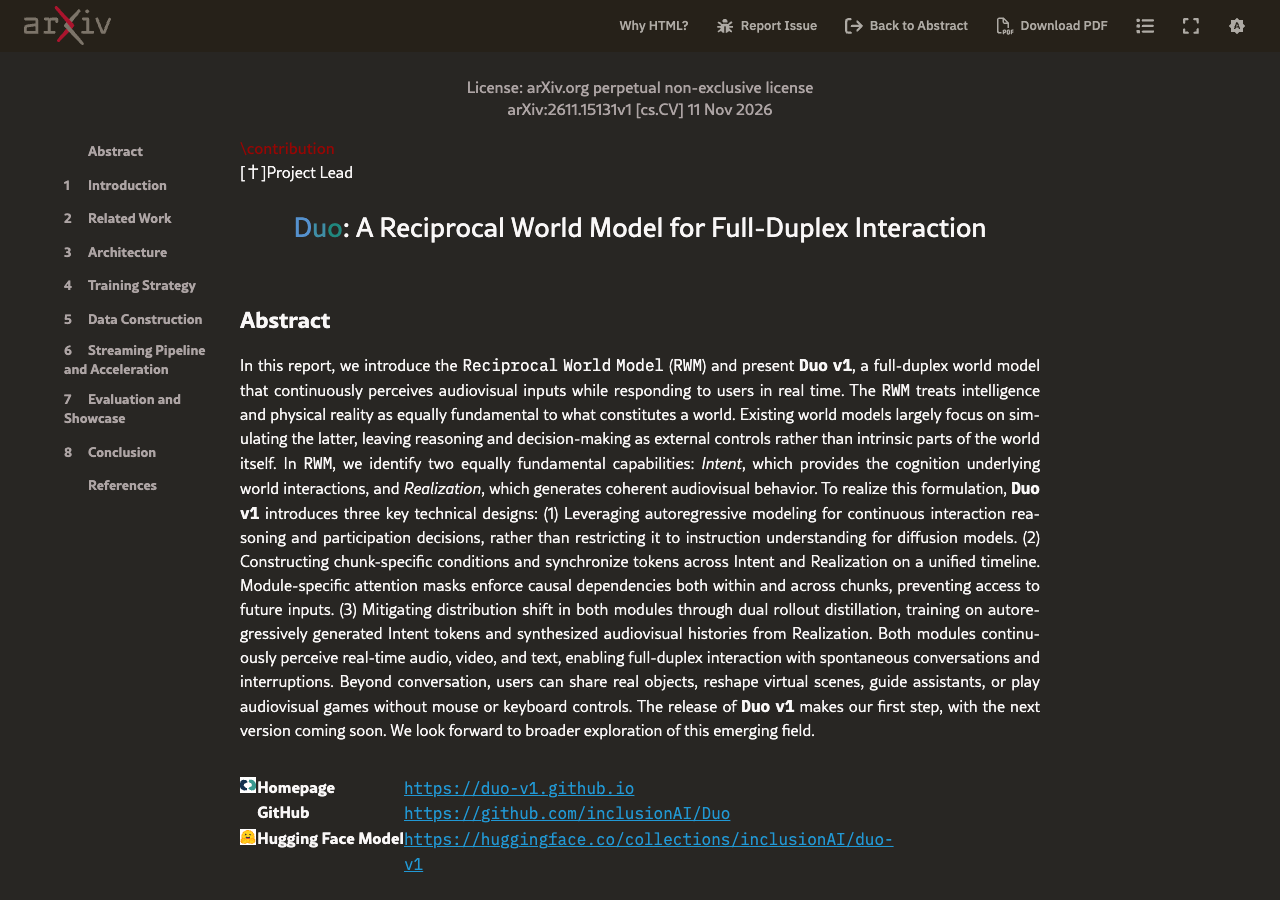
Duo v1は、映像付きの全二重会話を生成する研究モデル。利用者の映像と文字起こしを読み、返答中も入力を受け続ける。発話するか待つかを決めるVLMと、音声・映像を同時生成する拡散モデルを同期させる。著者の8 GPU構成では、推論・生成・転送等が330〜650msで、初回表示には復号と最大約708msの入力待ちも加わる。公開版は基本的な会話向けで、重みと推論コードが公開されている。
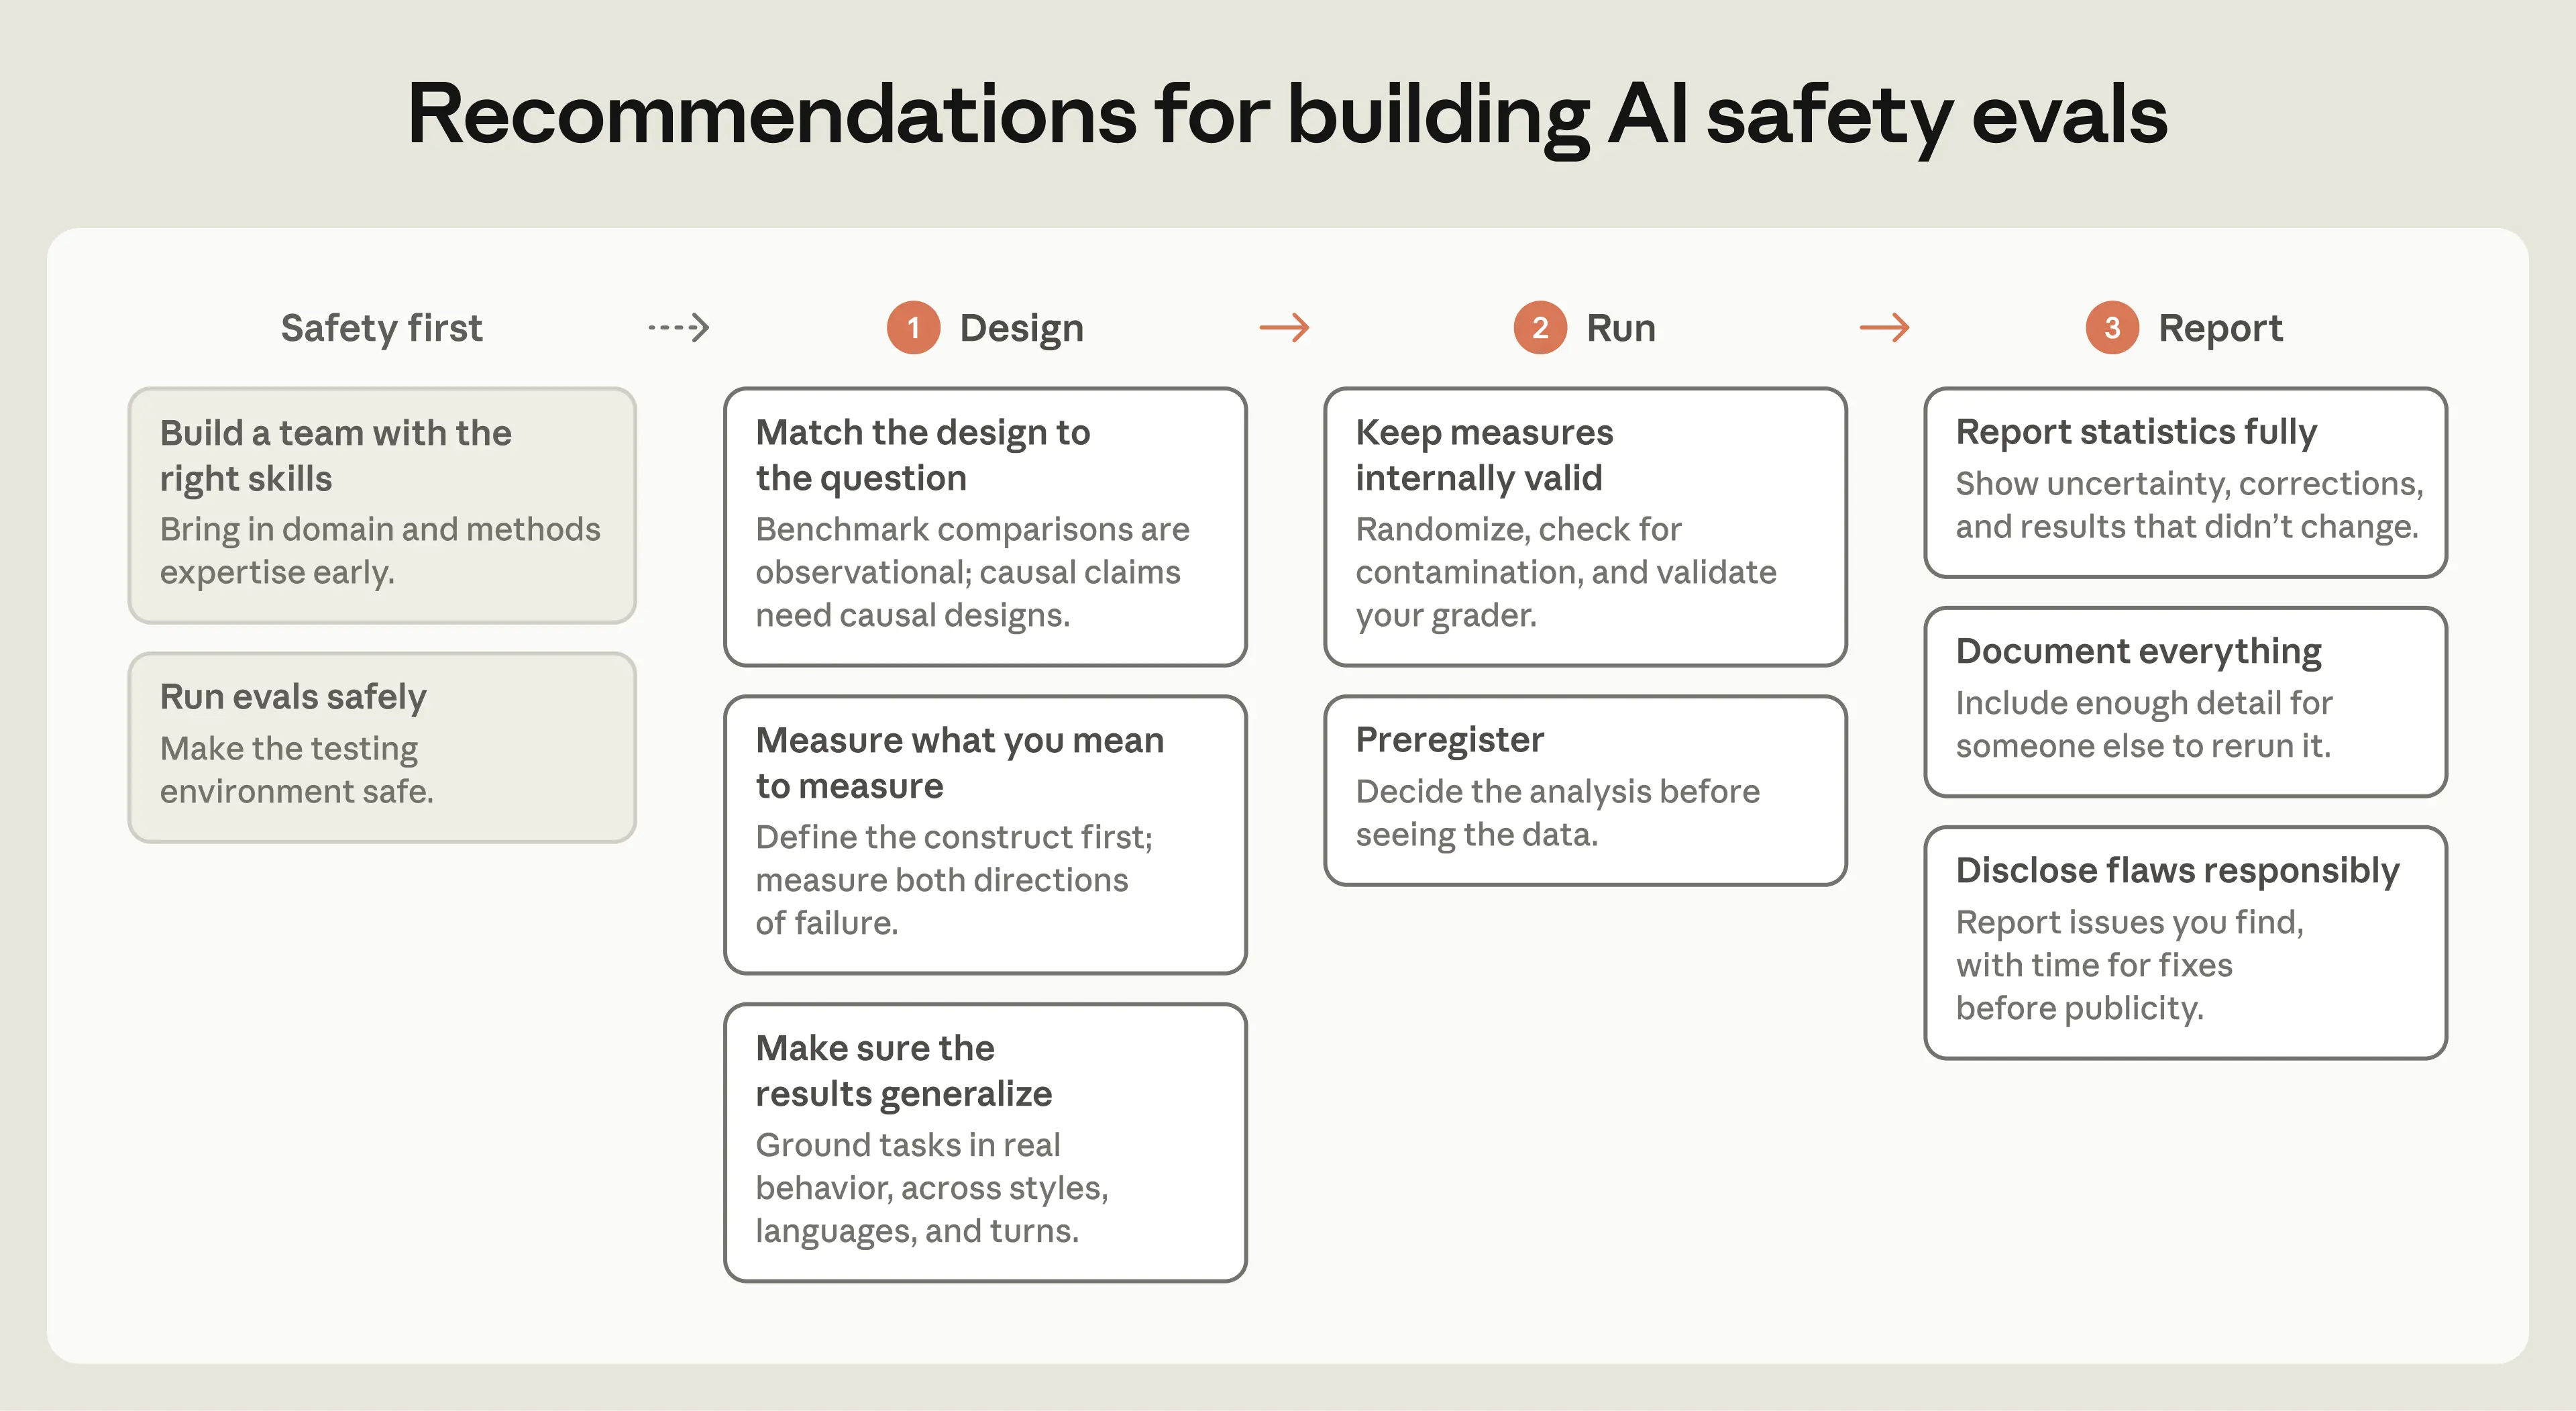
Anthropicによる、複数ターンの安全評価を設計する実装ガイド。単なる拒否率ではなく、対象領域の基準で会話全体を採点し、一度でも不適切な応答があれば失敗とする。評価器の基準を独立した二択項目に分け、人間の判定との一致を確認するほか、採点器の故障を黙って得点に混ぜない方法を示す。モデルや設定を比較するときは変更条件をそろえ、結果の不確実性も報告する。
2026年11月10〜15日を鮮度の上限範囲とし、直近成功号との24時間重複を含む11月13日以降を優先した。入力の86候補を見出し・抜粋とグループ情報で比較し、本文、論文要旨、保存された本文抜粋の確認範囲を区別して選定した。掲載する3件(安全評価ガイドを含む)は原文全体と関連する図・キャプションを確認した。公式Web一覧、製品・開発基盤の補完検索、YouTube検索も実施した。 高優先・実装候補30グループは原文確認を完了できず、掲載判断を保留して次回へ繰り越した。 既刊と同じ原記事1件は重複掲載せず。
全候補の論文全文まで確認したわけではなく、未確認候補を低価値とは判断していない。私的アーカイブの意味検索には5件の索引欠落があり、該当記事と掲載履歴を直接確認して補った。YouTubeはホームから動画一覧を抽出できず、検索でも採用に必要な公式動画の日付・内容を確認できなかった。一部モデルページはWeb取得に失敗したが、公開APIで重みファイルを確認した。3件とも画像を保存済みで、LLMONと安全評価ガイドは原記事の図、Duoは原記事冒頭のスクリーンショットを掲載する。部分確認の候補は私的記録に保留として残した。