NCCL Reshard、RL後学習の重み転送を高速化 ↗
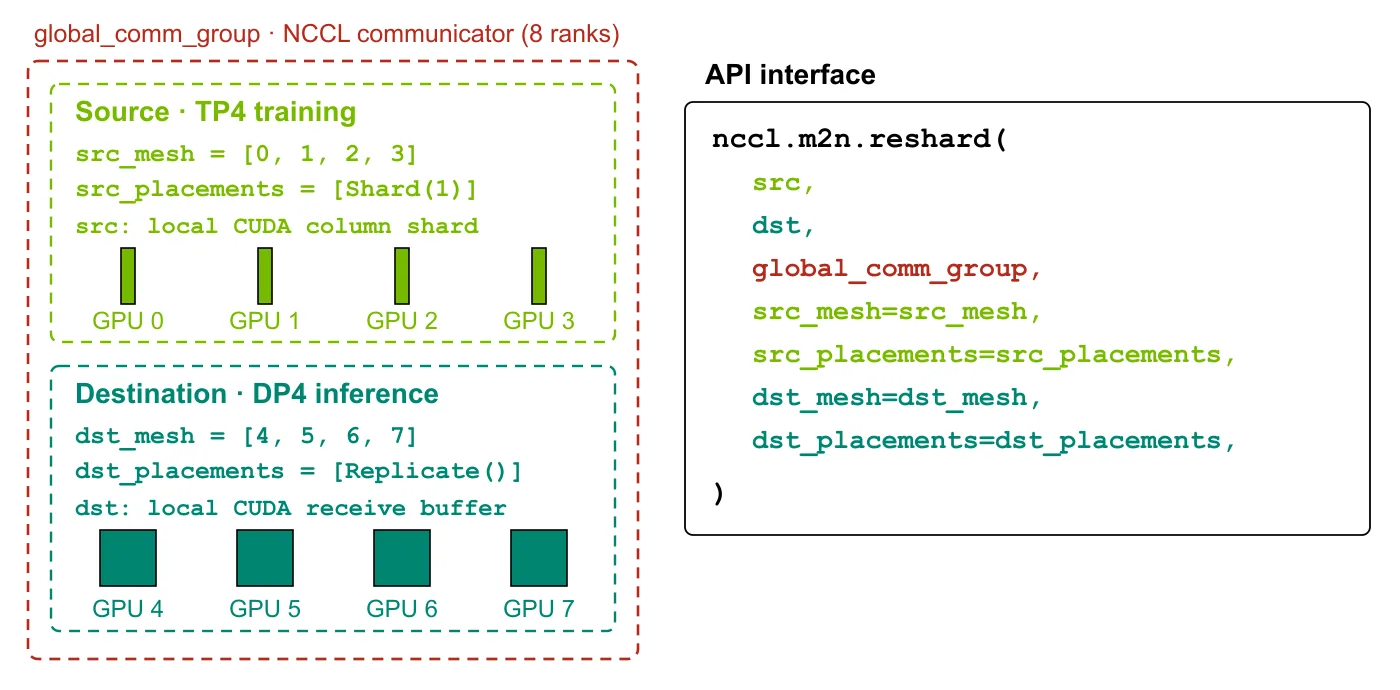
NCCL M2N Reshardは、強化学習の後学習で更新した重みを学習GPUから推論GPUへ転送する分散通信機能。GPU間で分割・複製したテンソルを表すPyTorchのDTensor同士を直接再配置し、複製先GPU間ではNVLinkで不足分を交換する。NeMo RLでは主要なフィードフォワード投影重みに適用し、小規模な重みは従来のgather-and-broadcast方式で転送する。NVIDIAのNeMo RL測定では、DGX H100/GB200上の複数モデルで、従来方式に比べ重み転送を2.7〜5.7倍高速化したと報告している。