SIGNAL2026-11-07 · AI TECH REPORT

Claude Codeの検索実験、サブエージェントの費用と結果取得を検証・StateBench、長文中の状態変化を4段階で評価など、AIの新情報

原文を確認できた8件のAI技術ニュースを紹介。

01yunany902026-11-06報告のみ

Claude Codeの検索実験、サブエージェントの費用と結果取得を検証 ↗

Claude Codeのコード検索で、Exploreサブエージェントの指定とeffort設定を比較した個人実験。6リポジトリの12問を288回実行した結果、発見率は各条件で97〜100%だった。著者の測定では、Opus 5.5のmedium条件でサブエージェントを指定すると、指示なしに比べ1回当たりのAPI費用が221%増えた。ヘッドレス実行では、サブエージェントを使った216回中210回で最初のresultに回答がなく、全resultの確認が必要だったと報告する。対象は1バージョン、中規模リポジトリ、各条件3回に限られる。
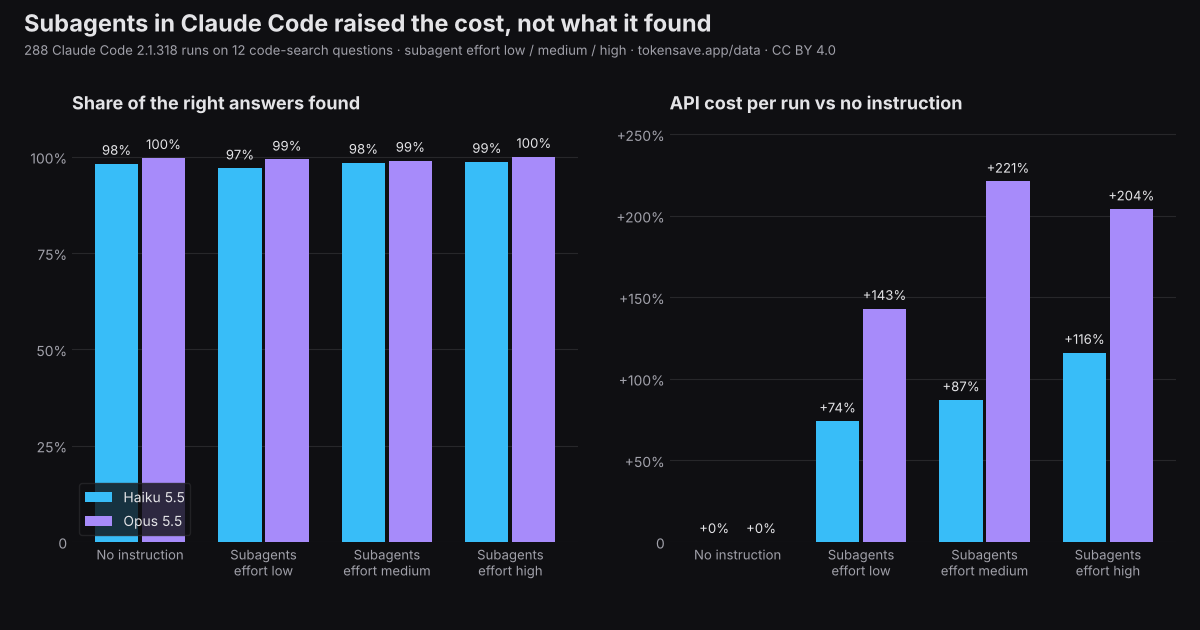
見つけた割合は横ばい、コストは増加
原記事に掲載された概要画像。
02Ai22026-11-03データ公開

StateBench、長文中の状態変化を4段階で評価 ↗

StateBenchは、長い入力の中で変数などの状態変化を追跡する能力を調べるベンチマーク。単純な値の取得から、他の変数を参照する連鎖的な更新まで4段階で比較する。Ai2の評価では、4つのフロンティアモデルの正答率は最も長い最高難度の課題で13%以下だった。課題は変数の数を固定しており、会話中に人物や物が新たに現れる状況は対象外。

StateBench、長文中の状態変化を4段階で評価:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
03Anthropic2026-11-06報告のみ

Anthropic、エージェント記憶の整理と誤り修正を検証 ↗

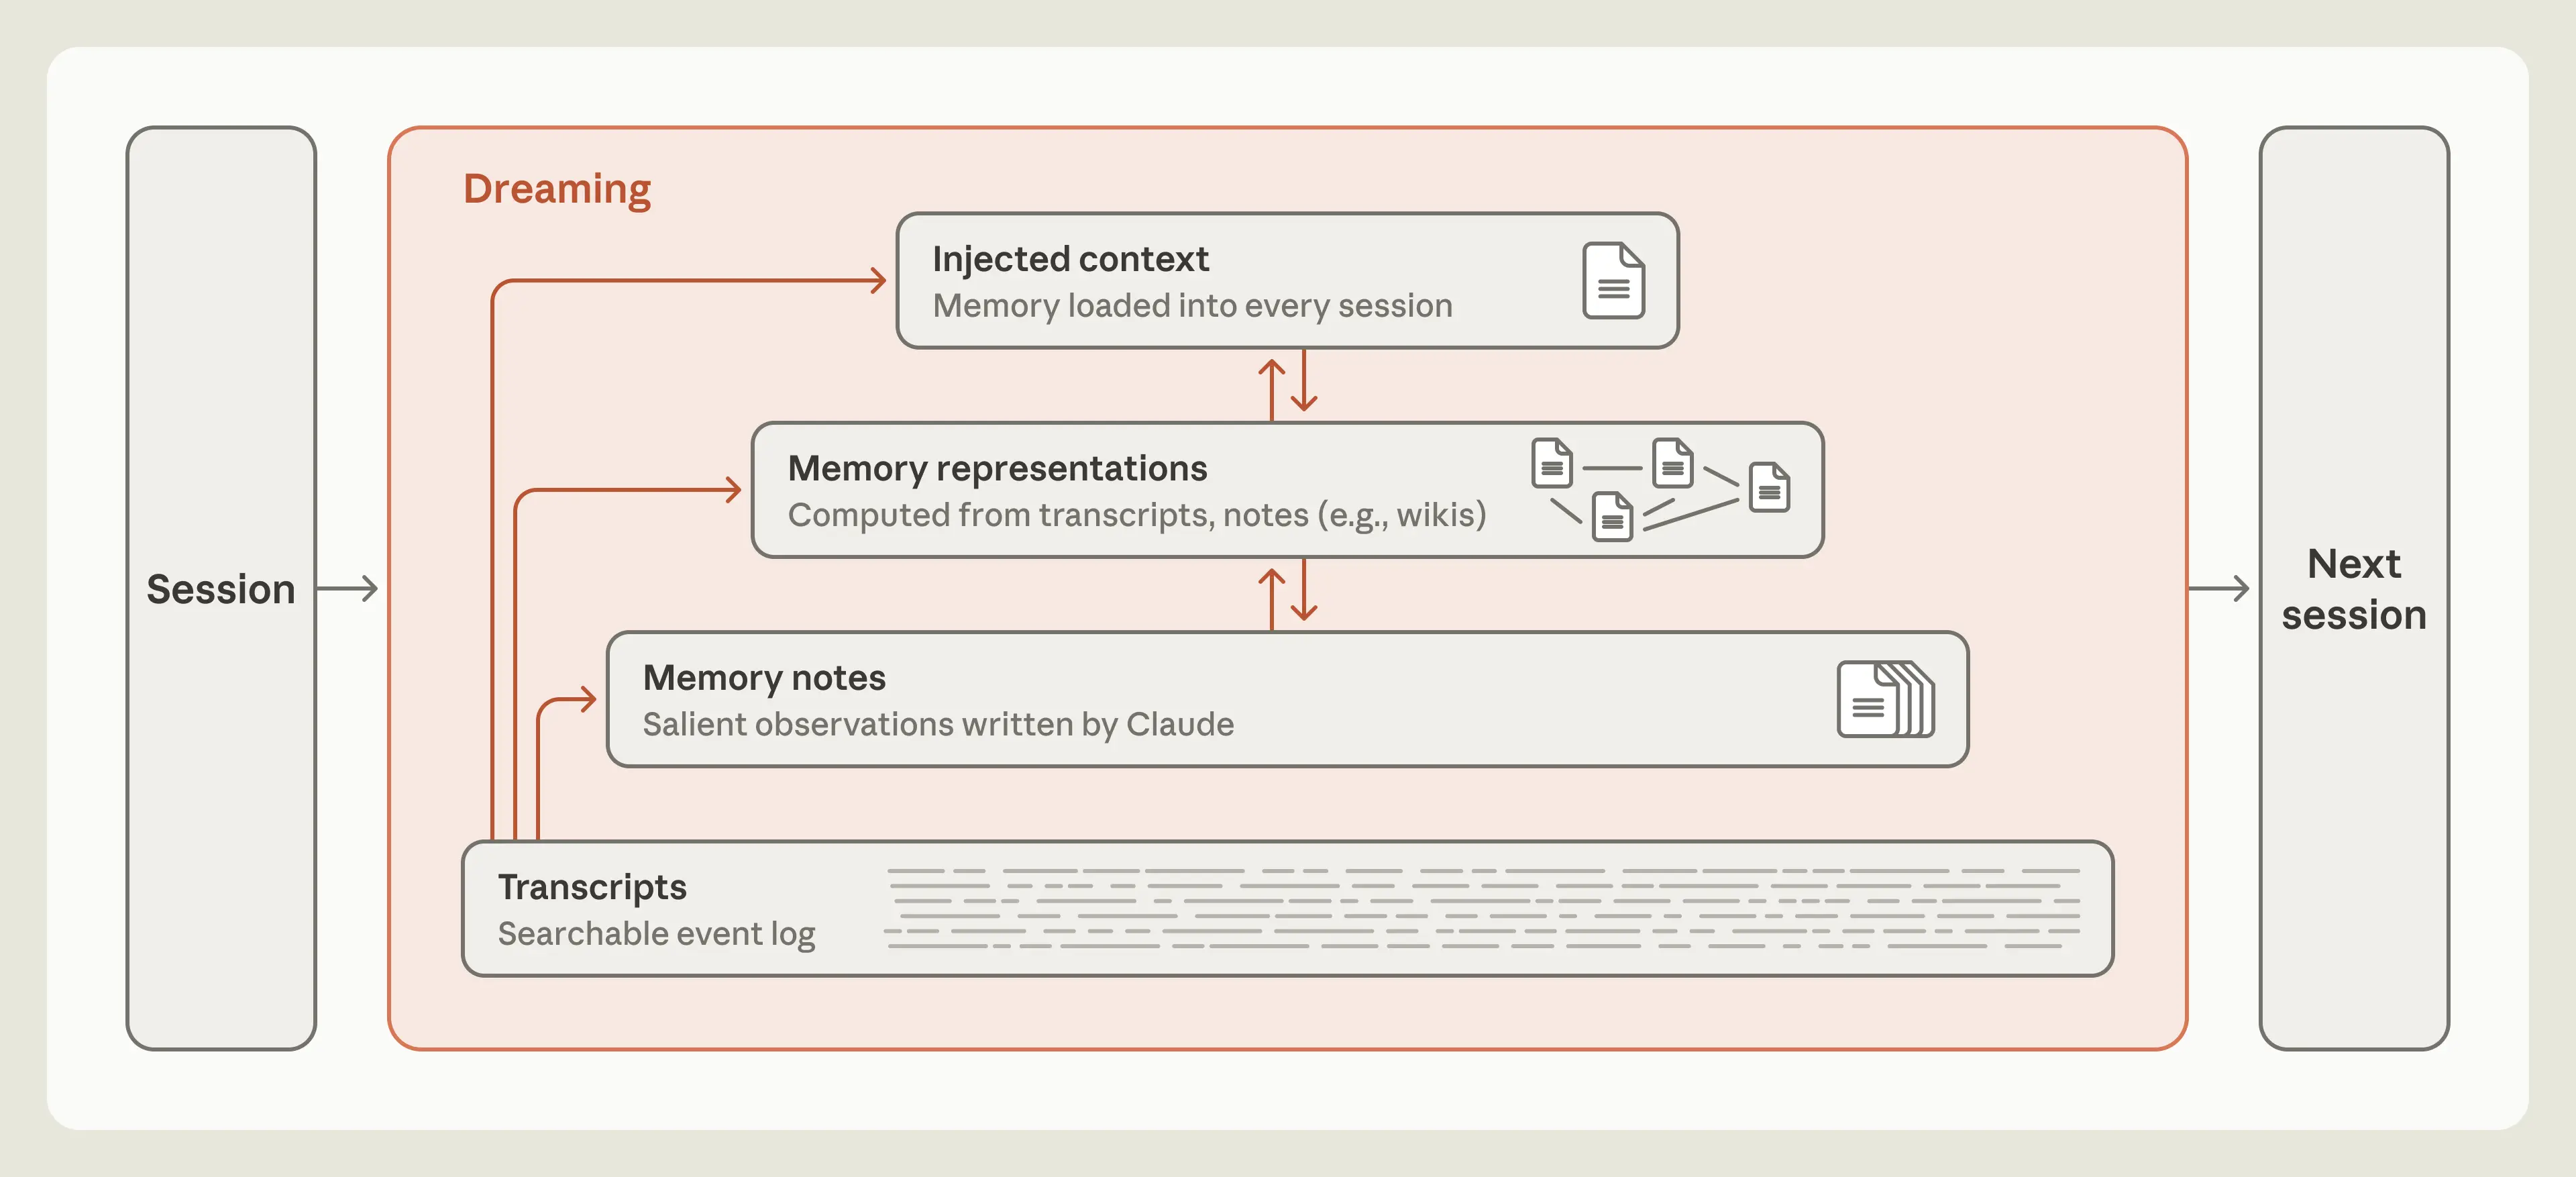
Anthropicは、AIエージェントがセッションをまたいで使う記憶の構成と整理方法を検証した。過去の記録をオフラインで見直す処理で誤ったメモを修正したり、検索用のWikiを構築したりする。社内文書についての25問では、検索のみの評価項目達成率53%に対し、十分に構築したWikiと検索の組み合わせは61%だった。一方、別の課題ではWikiの明確な改善がなく、維持には計算資源も必要としている。

Diagram of a memory hierarchy between one session and the next. From bottom to top: transcripts (a searchable event log), memory notes written by Claude, memory representations such as wikis, and injected context loaded into every session. Inside a box labeled “Dreaming,” arrows run from transcripts up to each layer, and in both directions between neighboring upper layers.
原記事に掲載された構成図。
04Collinear AI2026-11-03要セットアップ

CWE-bench v2、脆弱性の修正と既存機能を100課題で評価 ↗

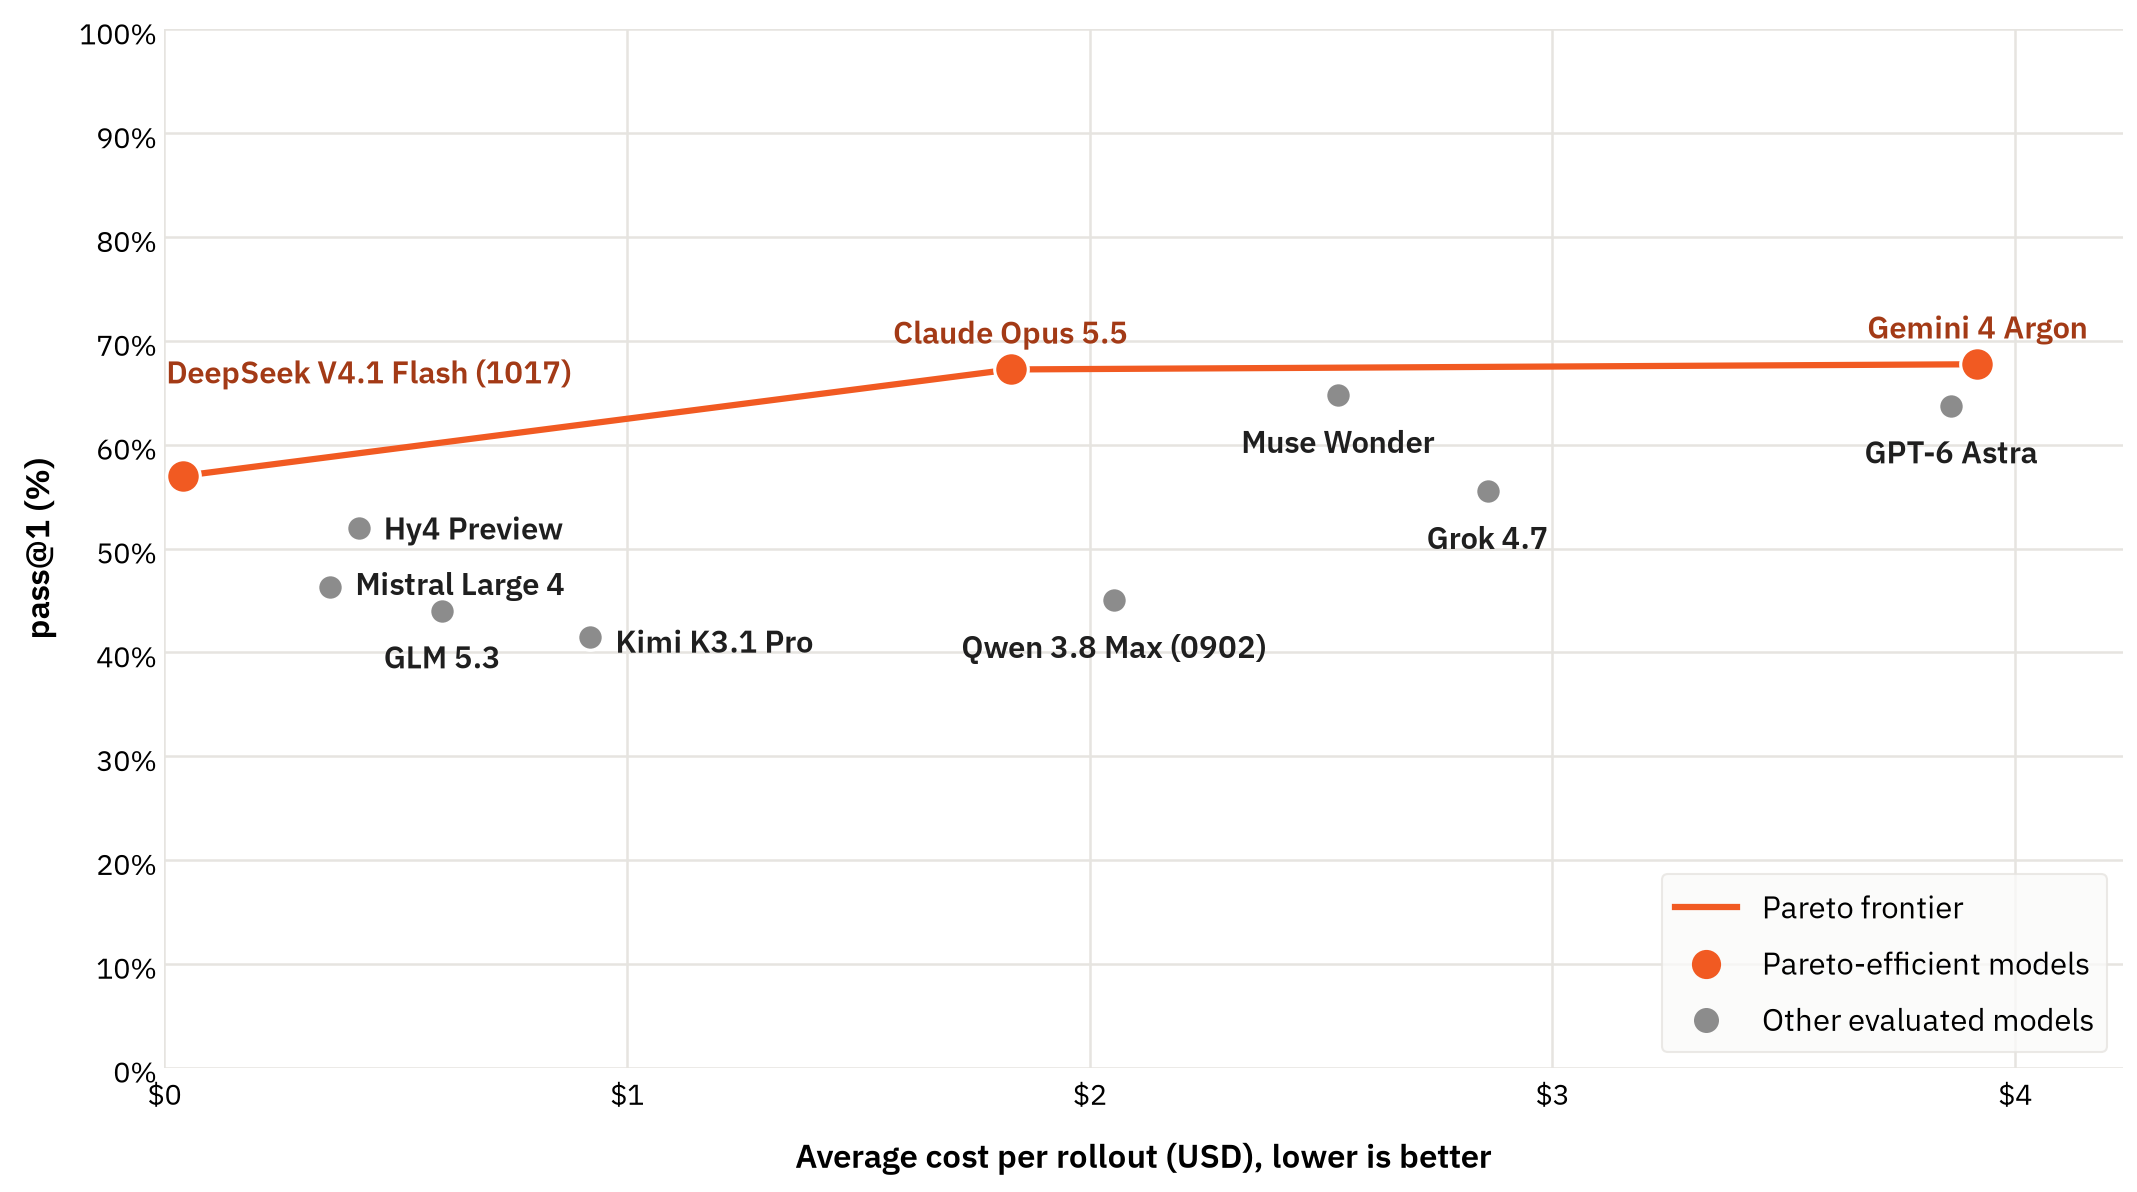
CWE-bench v2は、AIエージェントによる脆弱性の発見と修正を評価するベンチマーク。実際のオープンソースリポジトリを使う100課題で、脆弱性の種類を分類する91種類のCWEを扱い、修正後の挙動と既存機能をプログラムで検査する。公開課題と評価器はHarborで実行でき、防御エージェントの訓練報酬にも使える。ただし、このベンチマークで評価するモデルの訓練に課題や解答を使うことは禁止されている。データセットの利用にはアクセス条件への同意が必要で、非公開の評価セットは別途問い合わせが必要。

各モデルのpass@1と試行当たり平均費用の比較グラフ
各モデルのpass@1と試行当たり平均費用を比較した原記事のグラフ。
05NVIDIA2026-11-05要セットアップ

Cosmos 3、運転とロボット操作向けの世界モデル4種を公開 ↗

Cosmos 3 Nanoの追加4モデルは、運転やロボット操作に応じた映像を生成する公開重みの世界モデル。運転向けには複数視点の映像とLiDARを同期生成し、ロボット向けには操作から次の映像を予測する。シミュレータの状態から映像を生成するモデルでは、物理状態の計算はシミュレータが担う。閉ループ運転には別途シミュレーション実行環境が必要で、生成世界が学習や評価にどこまで忠実に使えるかは今後の検証課題。

Cosmos 3、運転とロボット操作向けの世界モデル4種を公開:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
06Mistral2026-11-05Webで利用

Mistral Studio、管理型エージェントとワークフロー構築を拡張 ↗

Mistral Studioは、企業向けのAIエージェント、ワークフロー、アプリを構築・運用する基盤。今回追加された管理型エージェントは、スキルやサブエージェントを使って複数段階のタスクを実行する。ワークフロービルダーでは、処理を自然言語で説明して生成・テスト・配置でき、生成コードも確認・編集できる。両機能は公開プレビューで、StudioにはMistral側、自社クラウド、オンプレミスなどの配置形態がある。

Mistral Studio、管理型エージェントとワークフロー構築を拡張:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
07NVIDIAほか2026-11-05研究段階

VFlash、視覚計画の座標をまとめて生成する研究 ↗

VFlashは、ロボットなどの視覚計画を生成する研究手法。位置や物体を示す点・境界ボックス、動きの予測を表す軌跡などの座標をまとめて出力する。固定した視覚言語モデルの特徴を使う軽量予測器を、注釈付き空間データで追加訓練する構成で、可変長の軌跡にも対応する。著者らの予備測定では、MolmoMotion-ARを使った3D点の動き予測の単一実行で、同モデルの自己回帰生成に比べ約25倍の生成速度だった。

VFlash論文の原記事冒頭画面
VFlash論文の冒頭画面(スクリーンショット)。
08上海交通大学ほか2026-11-03研究段階

Harness-S、別の実行支援での再試行をエージェント訓練に活用 ↗

Harness-Sは、エージェントの実行支援を変えて強化学習する研究手法。プロンプトやツールなどを含む元のハーネスで全試行が失敗した課題を、別のハーネスで再試行し、その軌跡を同じエージェントの訓練に使う。著者らのAppWorld・Qwen3.5-9Bの評価では、訓練後に元のハーネスへ戻した際のPass@3は72.52%で、通常のGRPOによる訓練の64.89%を上回った。Pass@3は3試行のうち少なくとも1回成功した課題の割合を示す。

Harness-S論文の原記事冒頭画面
Harness-S論文の冒頭画面(スクリーンショット)。

確認範囲と不足

2026-11-07の調査。掲載案18件を評価し、原文確認と既刊照合を通過した8件を掲載。全候補の本文を網羅した調査ではない。

全候補の本文確認と全情報源のライブ一覧確認は完了していない。高優先候補の多くは未審査のままであり、重要なニュースが他にないという結論は出せない。YouTubeは指定された再試行日より前のため、検索結果を得られず、直接の再確認も行っていない。私的アーカイブの意味検索は索引148件中3件が未収録で、網羅性は部分的だった。ToyBlocksの原図は取得・検査できなかったため、図に依存する性能値と画像は掲載していない。 原文の再確認に失敗し掲載保留:Images 2.6、GIF制作と画像編集のAPI操作を拡張

掲載しなかった候補 62件採点済みと未採点を分けて確認