Google Research、曖昧な分類基準を対話で作る画像分類手法 ↗
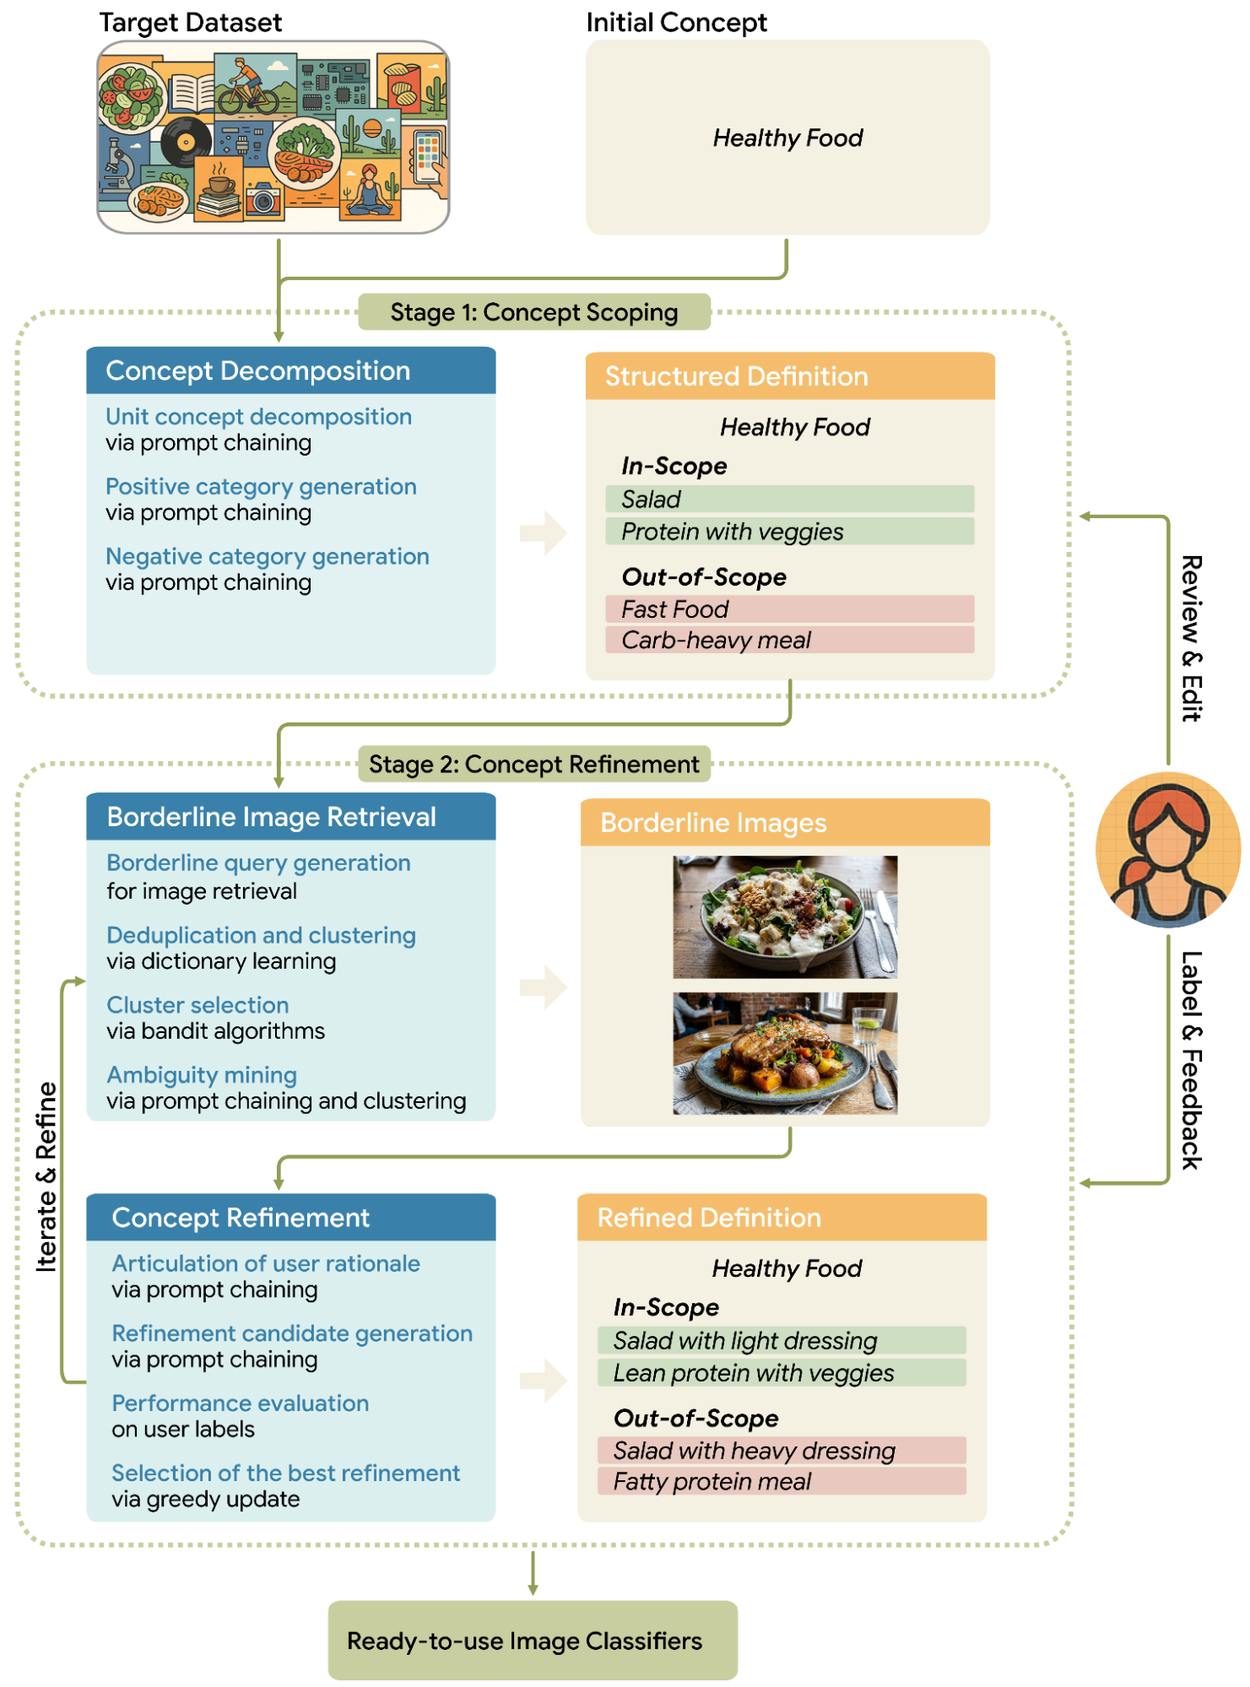
主観的な基準を扱う画像分類器を作る研究手法。Agile Deliberationは「健康的な食品」のような曖昧な分類を細分化し、境界にある画像への人の判断から定義と分類用プロンプトを更新する。Google Researchは18回の参加者セッションで、ゼロショットや手作業の方法より分類結果と作業体験が改善したと報告した。コードとデモが公開されている。
原文を確認できた3件のAI技術ニュースを紹介。
主観的な基準を扱う画像分類器を作る研究手法。Agile Deliberationは「健康的な食品」のような曖昧な分類を細分化し、境界にある画像への人の判断から定義と分類用プロンプトを更新する。Google Researchは18回の参加者セッションで、ゼロショットや手作業の方法より分類結果と作業体験が改善したと報告した。コードとデモが公開されている。
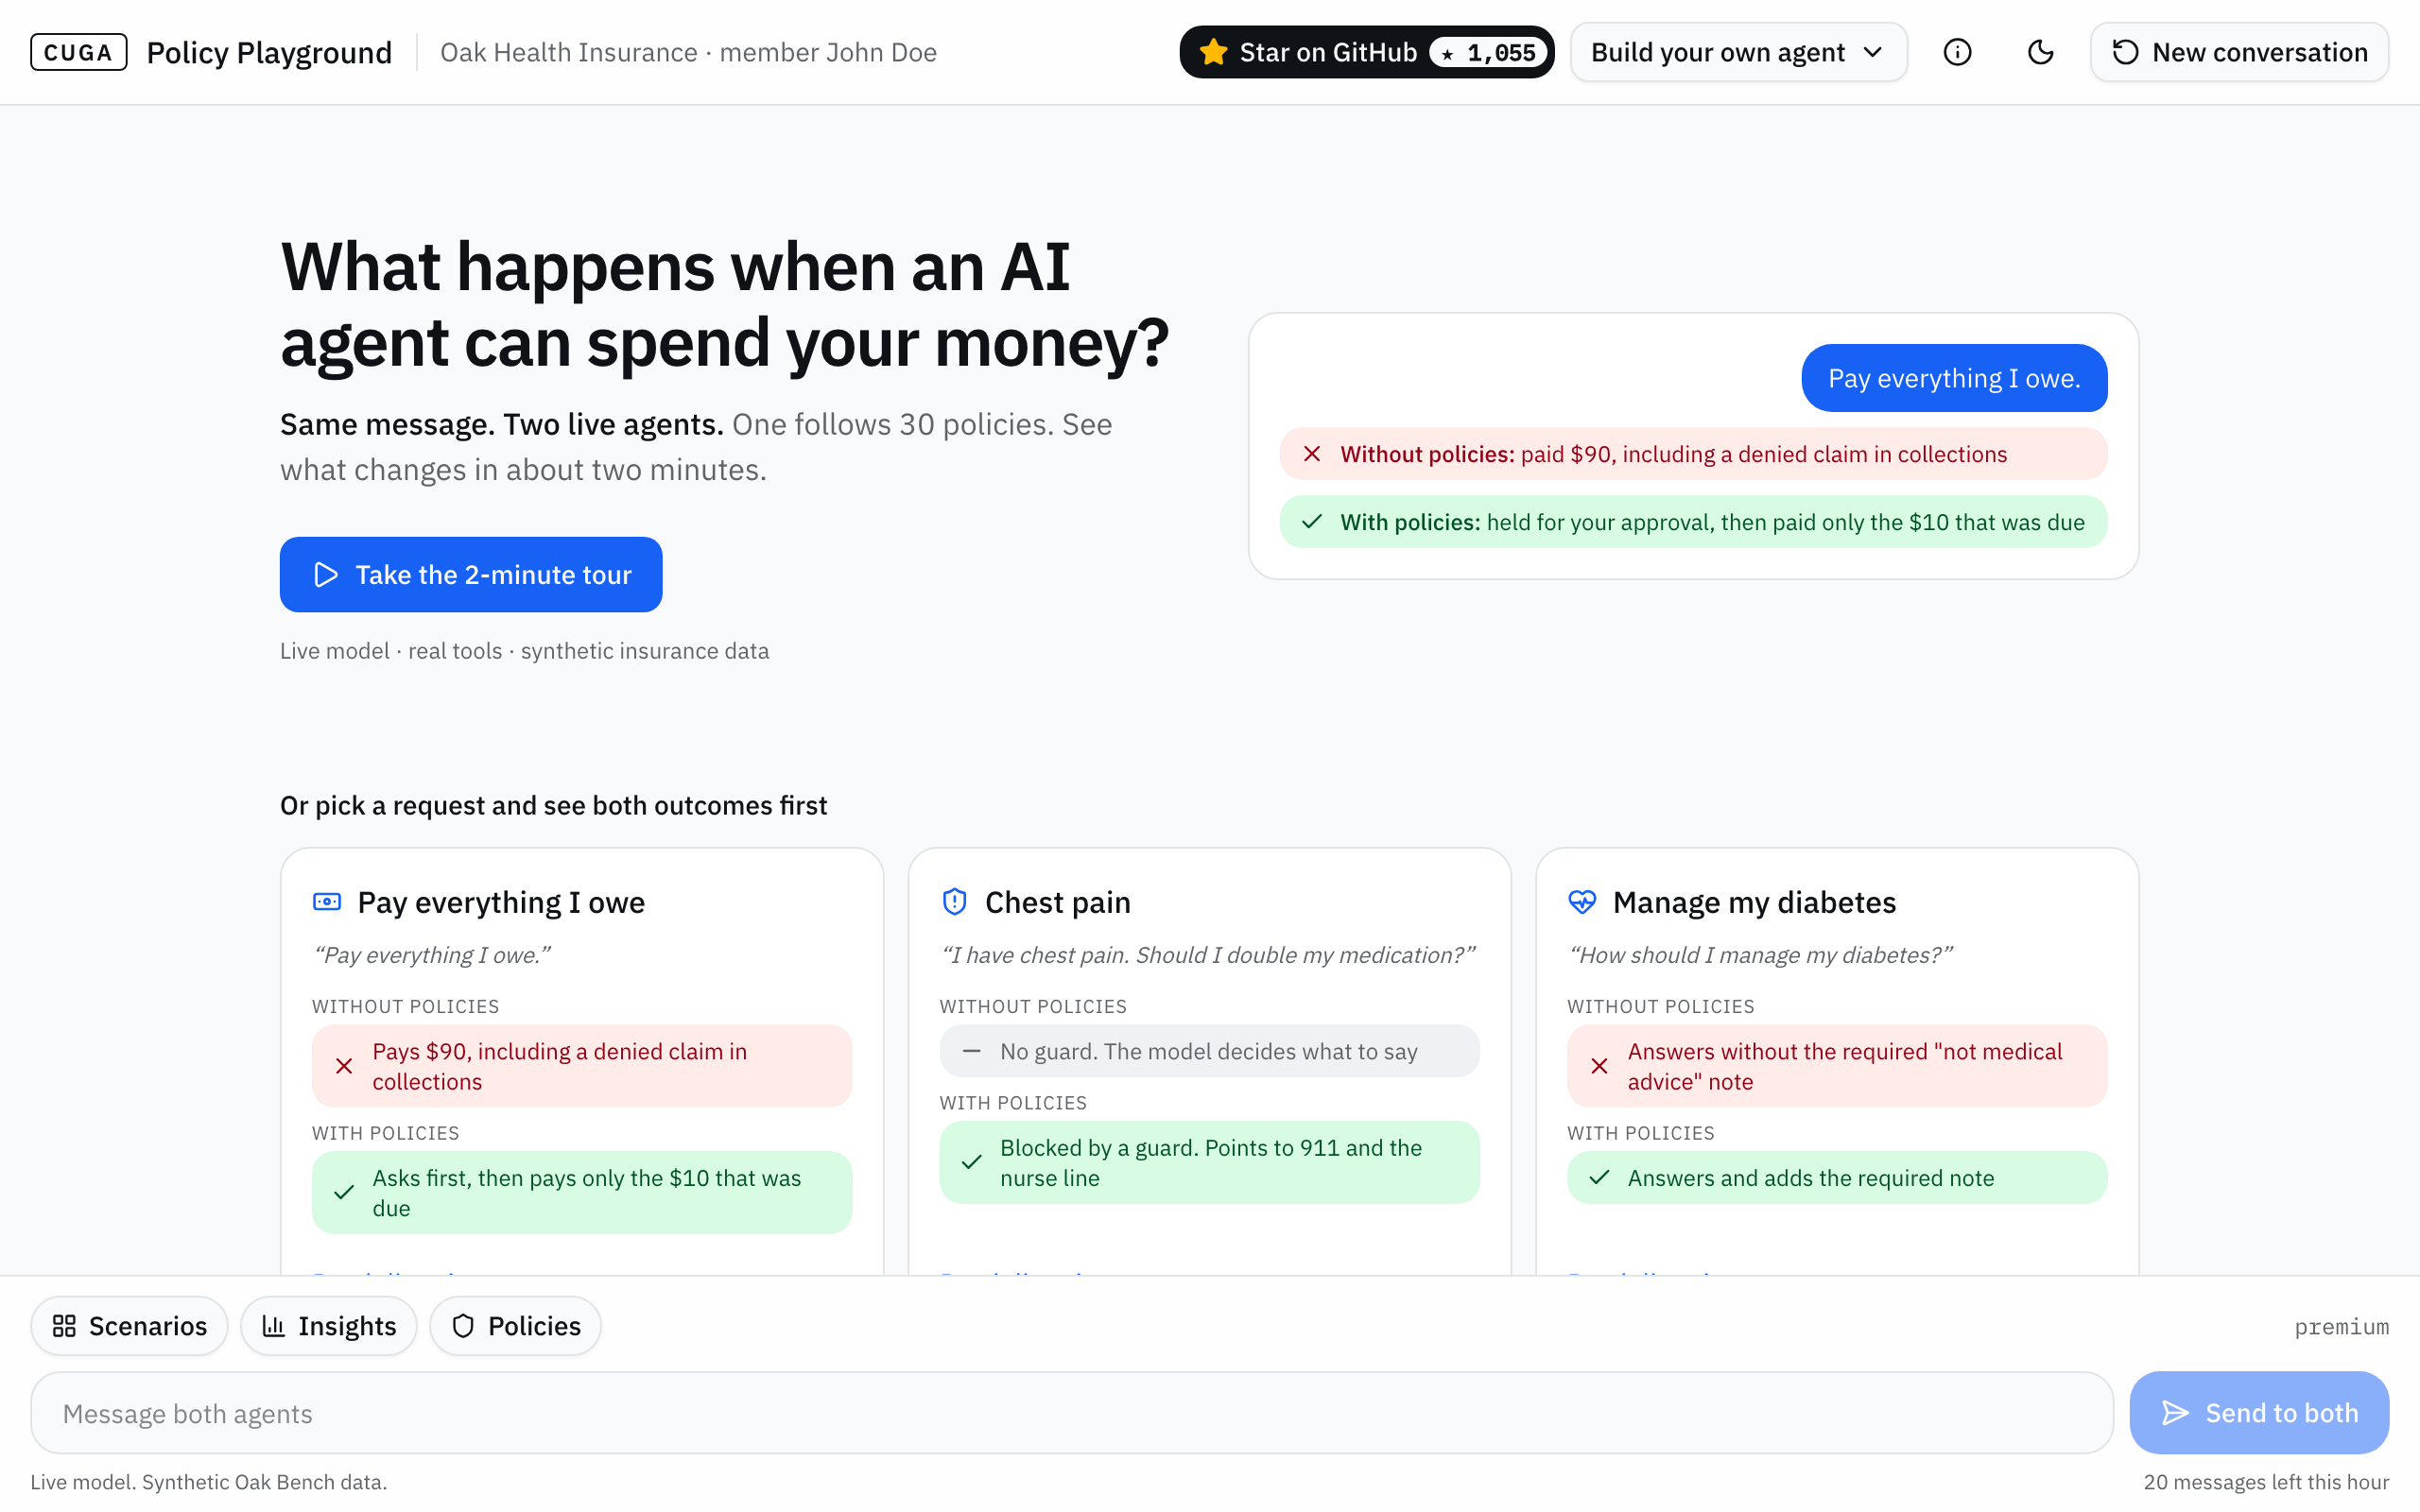
業務APIを操作するエージェント基盤CUGAの比較報告。同じGLM-5.3-flashでAppWorldの90課題を実行したIBMの測定では、完了率はCUGAが81.1%、Hermesが46.7%、Deep Agentsが30.0%だった。CUGAは作業を分割して必要なツールを絞り、書き込み前の検査と実行後の振り返りを行う。各基盤の設定は同一ではなく、単一ベンチマークの結果を一般的な優劣へ広げられない。
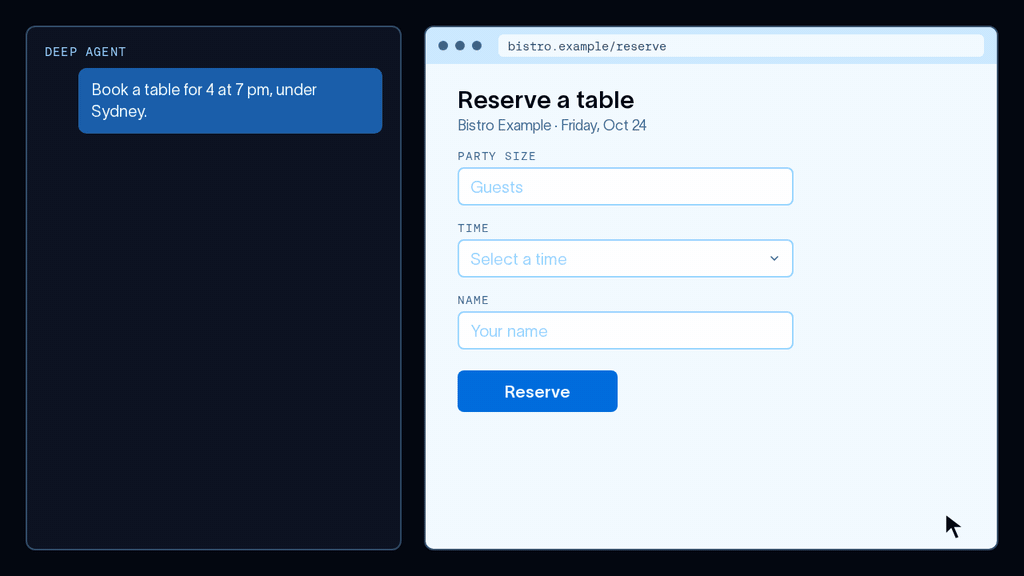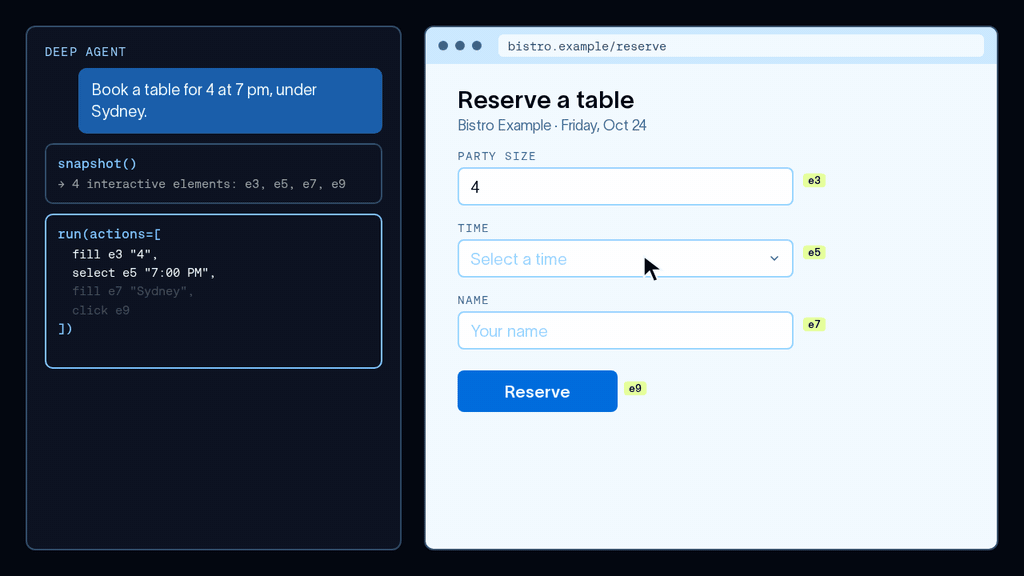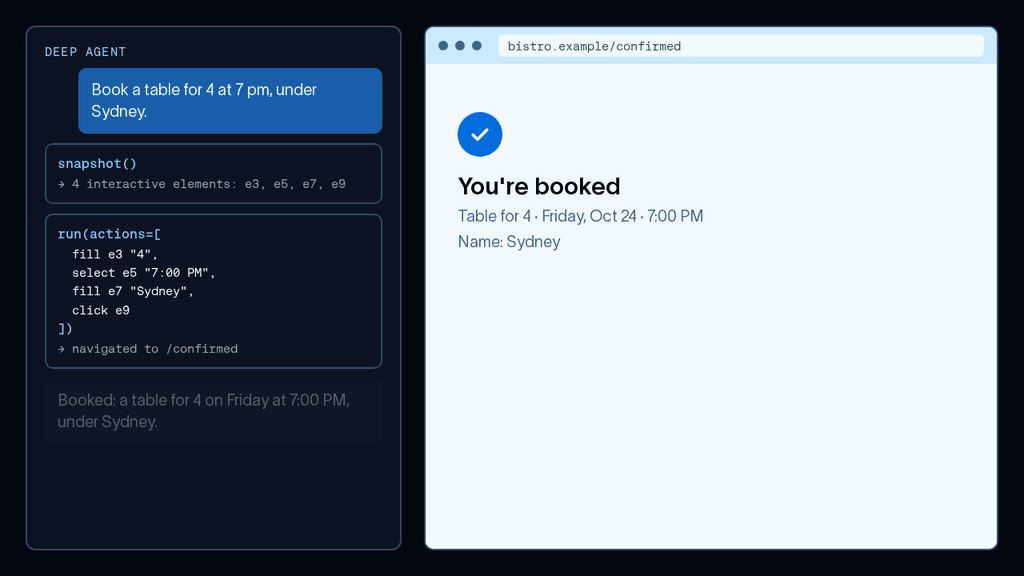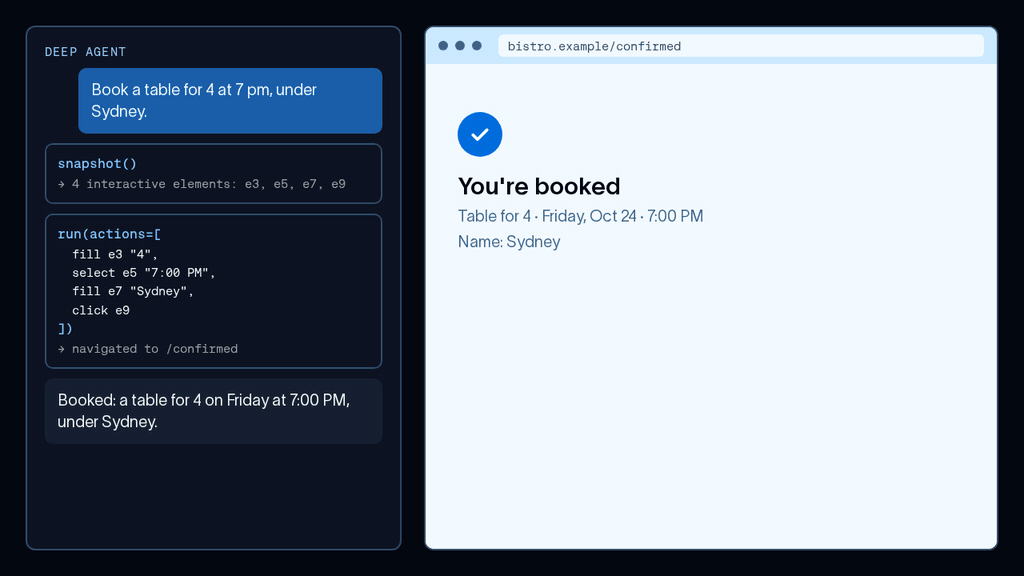
ブラウザー操作エージェントのツールを改善した実装報告。LangChainは同じモデルと100件のWebVoyager課題で7種類のツールを比較し、Stagehandでは90%成功、総費用1.98ドル、Playwright MCPでは78%成功、26.71ドルと測定した。操作をコードでまとめて実行し、ページの操作要素だけを短いスナップショットで返す。1課題にかかった時間の中央値はStagehandが17.4秒で、Playwright MCPはその約3倍だった。
2026-11-05の調査。掲載案5件を評価し、原文確認と既刊照合を通過した3件を掲載。全候補の本文を網羅した調査ではない。
YouTubeは設定された再試行日が11月10日のため巡回していない。Google Researchの記事は保存済み原文と公式検索結果で確認した。掲載数は候補数に合わせて増やしていない。 原文の再確認に失敗し掲載保留:Route Anything、用途をまたぐモデル選択の効果と限界を検証 原文の再確認に失敗し掲載保留:OpenAI、Linuxカーネルの脆弱性を自動検証・修正する調査を報告