SIGNAL2026-11-03 · AI TECH REPORT

SGLang、GPUメモリに収まらないMoEモデルの推論に対応・vLLM、投機的デコードの処理改善とCUDA配布条件の変更など、AIの新情報

原文を確認できた3件のAI技術ニュースを紹介。

01SGLang2026-11-02要セットアップ

SGLang、GPUメモリに収まらないMoEモデルの推論に対応 ↗

SGLang 0.5.23は、LLMや画像生成モデルを動かす推論基盤の更新。新しいPaged Expertsを有効にすると、重みがGPUメモリに収まらないMoEモデルも単一GPUで実行できる。提供元は16GB GPUでの単一ストリームのデコードを、従来のCPUオフロードと比べて12〜30倍高速と報告している。Google TPU7x向けのPyTorchプラグインにも対応し、明示的に有効化する新しいエンジンで量子化MoEモデルのLoRAアダプターを配信できる。
SGLang、GPUメモリに収まらないMoEモデルの推論に対応:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
02vLLM2026-11-02要セットアップ

vLLM、投機的デコードの処理改善とCUDA配布条件の変更 ↗

vLLM v0.33.0は、LLM推論基盤の更新。DFlash・DSparkの投機的デコードで推測用トークン枠を予約しないようにした。開発側の測定では、GB300上のDeepSeek-V4.1-FlashとDSparkの出力処理量が毎秒1,373から3,390トークンになった。このリリースのCUDA向けwheelとイメージは13.0のみで、12.9向けは提供されない。ページの表示名はv0.33.0だが、URL上のタグはv0.33.0rc3。

vLLM、投機的デコードの処理改善とCUDA配布条件の変更:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
03Microsoft2026-11-02報告のみ

Microsoft、エージェント開発の検査とPythonからRustへの移行事例を公開 ↗

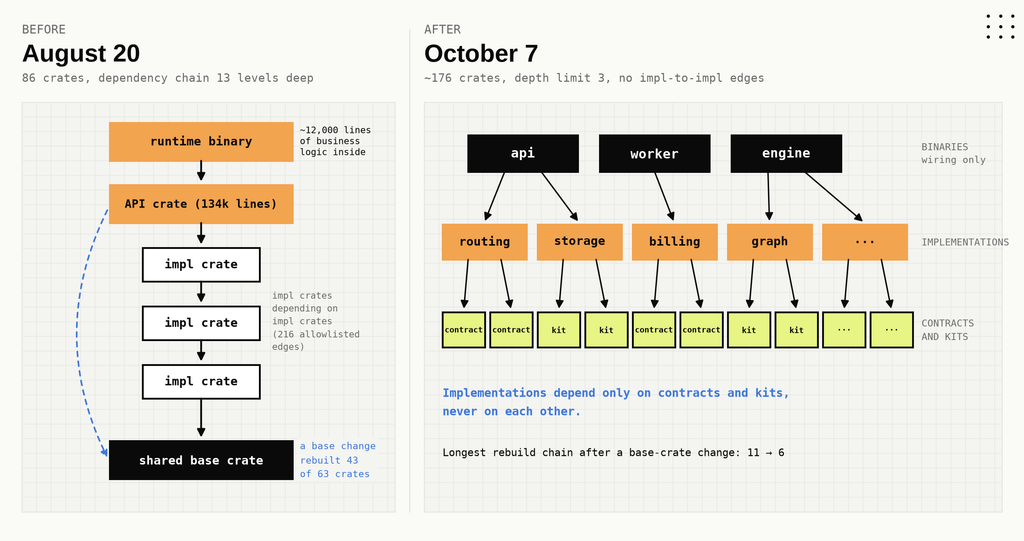
Microsoftは、Copilot Coworkの開発でコーディングエージェントを使った事例を報告した。検査対象の件数を出力し、検査が意図的に失敗することも試すほか、重要な変更には人間のレビューを残した。稼働中のPython実装からRustへ移す際は、元の実装を実行して入出力を記録し、新実装で再現するテストを用意した。イベント順序を記録していなかったためにテストで見逃した問題もあったという。

Rustワークスペースの依存関係を整理前と整理後で比較した図
実装同士の依存を契約経由に整理した前後の構成。出典:Microsoft

確認範囲と不足

2026-11-03の調査。掲載案5件を評価し、原文確認と既刊照合を通過した3件を掲載。全候補の本文を網羅した調査ではない。画像はSGLangとvLLMの原記事冒頭のスクリーンショット、およびMicrosoftの記事の構成図を保存した。

調査は部分的。高優先候補の一部は原文を取得できず、公開済み記事の意味検索索引にも欠落が3件あった。GitHubの一部リリースページは保存時点と異なる内容を返し、指定日の版を確定できなかった。YouTubeホームは動画一覧を抽出できず、検索結果だけでは新着動画の原本を確認できなかった。週次ソース点検は全対象の7日間の根拠を評価し終えていないため、判断を返していない。未確認候補があるため、他に重要なニュースがないとは判断できない。

掲載しなかった候補 81件採点済みと未採点を分けて確認