SIGNAL2026-11-02 · AI TECH REPORT

LLMエージェントの出力検査と評価器を一緒に保守するなど、AIの新情報

確認した新情報から1件を紹介。

01Zenn / h.f2026-11-02報告のみ

LLMエージェントの出力検査と評価器を一緒に保守する ↗

これは、業務データを分析してレポートを返すLLMエージェントの品質検査に関する実装報告。著者の現場では、業務ケース・データ・期待値を固定し、数値は機械的に、分析の妥当性はLLMで評価した。PR時に検査が失敗するとCIを止め、出力と判定理由を確認してエージェントの誤りと評価器の誤判定を切り分け、修正後に再実行していた。評価例の追加で判定の揺らぎは減ったものの、完全にはなくならなかった。記事は同じ基盤をモデル移行時の比較に使う方法も提案しているが、移行を完了した実績の報告ではない。
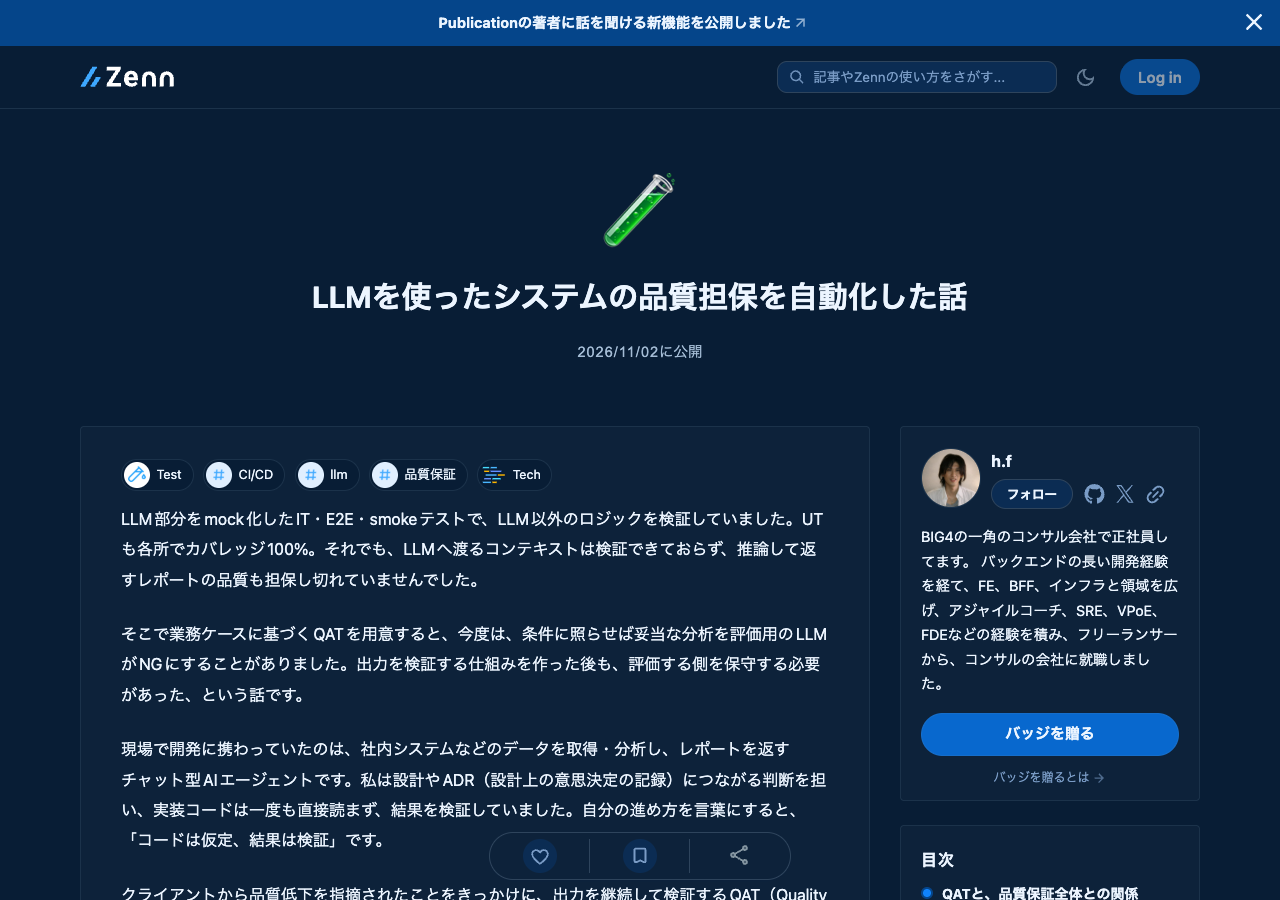
LLMエージェントの出力検査と評価器を一緒に保守する:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。

確認範囲と不足

10月28日から11月2日までを鮮度範囲として、収集済み候補と公式記事を一部確認した。Managed Deep Agents、OpenWiki、AnySpeechRecognizer/AnyDecisionModelは同じ発表が既刊に含まれる。Mistral Large 4の重み公開は既刊後の変更だが、その実用上の差の評価は完了していない。

全ての高優先候補、実装ガイド、指定されたWeb一覧の確認は完了していないため、重要な新着が存在しないとは判断できない。ZennとQiitaの対象記事はライブ本文取得に失敗した。YouTubeは指定されたアクセス制限の再試行日より前だったため確認していない。既刊の意味検索インデックスは一部欠落していた。

掲載しなかった候補 47件採点済みと未採点を分けて確認