Managed Deep Agents、ログイン時のブラウザー引き継ぎと非同期サブエージェントを追加 ↗
Managed Deep Agents v0.10は、Web操作と非同期サブエージェントに対応した管理型エージェント基盤の更新。APIのないWebサイトをサンドボックス内のブラウザーで操作し、ログインが必要な場面では人に操作を渡せる。長い作業は非同期サブエージェントに任せ、その間も親エージェントは利用者との会話を続け、完了後に結果を受け取る。v0.10は公開ベータで提供される。
原出典を確認できた3件を紹介。
Managed Deep Agents v0.10は、Web操作と非同期サブエージェントに対応した管理型エージェント基盤の更新。APIのないWebサイトをサンドボックス内のブラウザーで操作し、ログインが必要な場面では人に操作を渡せる。長い作業は非同期サブエージェントに任せ、その間も親エージェントは利用者との会話を続け、完了後に結果を受け取る。v0.10は公開ベータで提供される。
Apple端末向けの音声認識と定型判断を扱う2つのSwiftパッケージ。AnySpeechRecognizerはAppleのSpeech APIに近い形でParakeetやQwen3-ASRを選び、音声を文字起こしできる。Parakeetは日本語に対応せず、Qwen3-ASRは対応する。AppleまたはParakeetの認識器にSortformerを併用すると、最大4人の話者を区別できる。AnyDecisionModelは問い合わせ文から担当部署を選ぶなど、選択肢や評点をモデルの確率に基づいて返し、端末上のMLXモデルに加え、Jevなどのホスト型バックエンドも使える。提供元がM4 Maxで3~8分のファイル音声を測定したところ、LibriSpeech test-cleanの単語誤り率はParakeet v3が1.55%、Appleの認識器が2.12%だった。
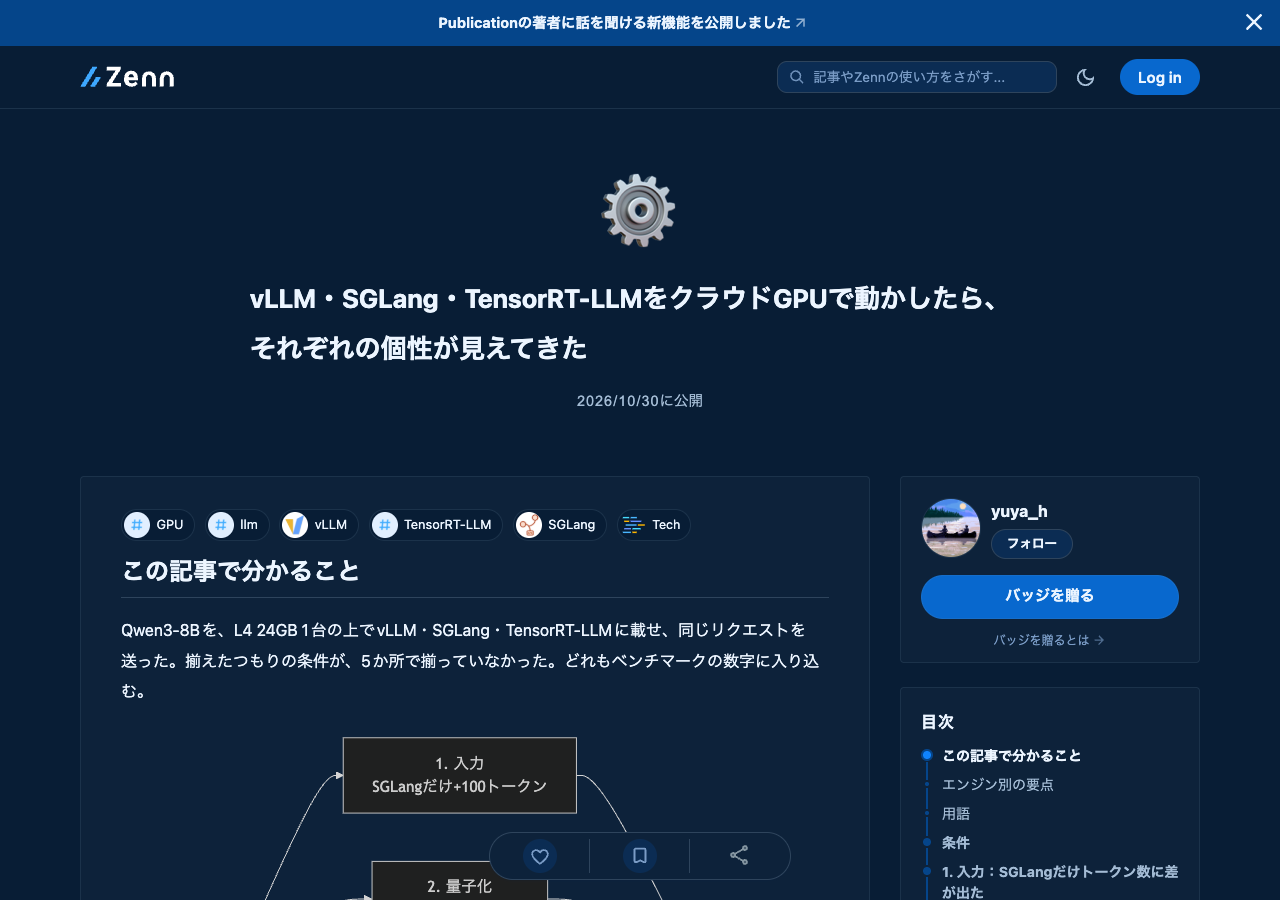
LLM推論エンジンの比較条件を検証した実装ガイド。著者はQwen3-8BをL4 GPU上の3エンジンに載せ、同じリクエストでもSGLangではツール定義の変換で入力が100トークン増えることを確認した。またFP8の実際の計算方式、KVキャッシュ容量、混雑時の待機・追い出し、キャッシュの残り方が測定値に混ざる。速度の順位は示さず、入力と実行条件を揃えるための確認方法を提示している。
取得済み候補を調べ、原出典を確認できた3件を掲載。3件とも原記事の冒頭画面のスクリーンショットを保存済み。
Google Cloudのロボティクス記事は原文本文を取得できず、掲載を保留した。YouTubeの候補は動画本文と公開日を確認できず、掲載を保留した。確認できた範囲を超えて重要ニュースが存在しないとは判断しない。