SIGNAL2026-10-17 · AI TECH REPORT

AI技術5件:コンピューター操作から対話アバターまで

2026年10月17日付。コンピューター操作、音声ターン判定、ウェットラボ、気候シミュレーション、対話アバターに関する発表5件を紹介する。

今回の調整:同一発表の重複と既刊記事の再掲載を避け、選定済みの5件を維持した。

01Alibaba Tongyi-MAI2026-10-15要セットアップ

OpenGCUA:GUIとコード実行を組み合わせる公開コンピューター操作基盤 ↗

OpenGCUAは、画面操作とコード実行を組み合わせるコンピューター操作エージェントの公開基盤。モデルが観測方法と操作方法を選び、GUI操作の途中でファイルや実行結果を調べられる。著者らのOSWorld-v2評価では、8モデル平均の部分得点がGUIだけの構成より19.6ポイント高く、報告された操作ステップは53.0%少なかった。実装、プロンプト、実行記録と初期段階の実機用基盤を公開しており、専用の学習済みモデルはまだ含まれない。
OpenGCUA:GUIとコード実行を組み合わせる公開コンピューター操作基盤:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
02Austin Xiaoほか2026-10-15要セットアップ

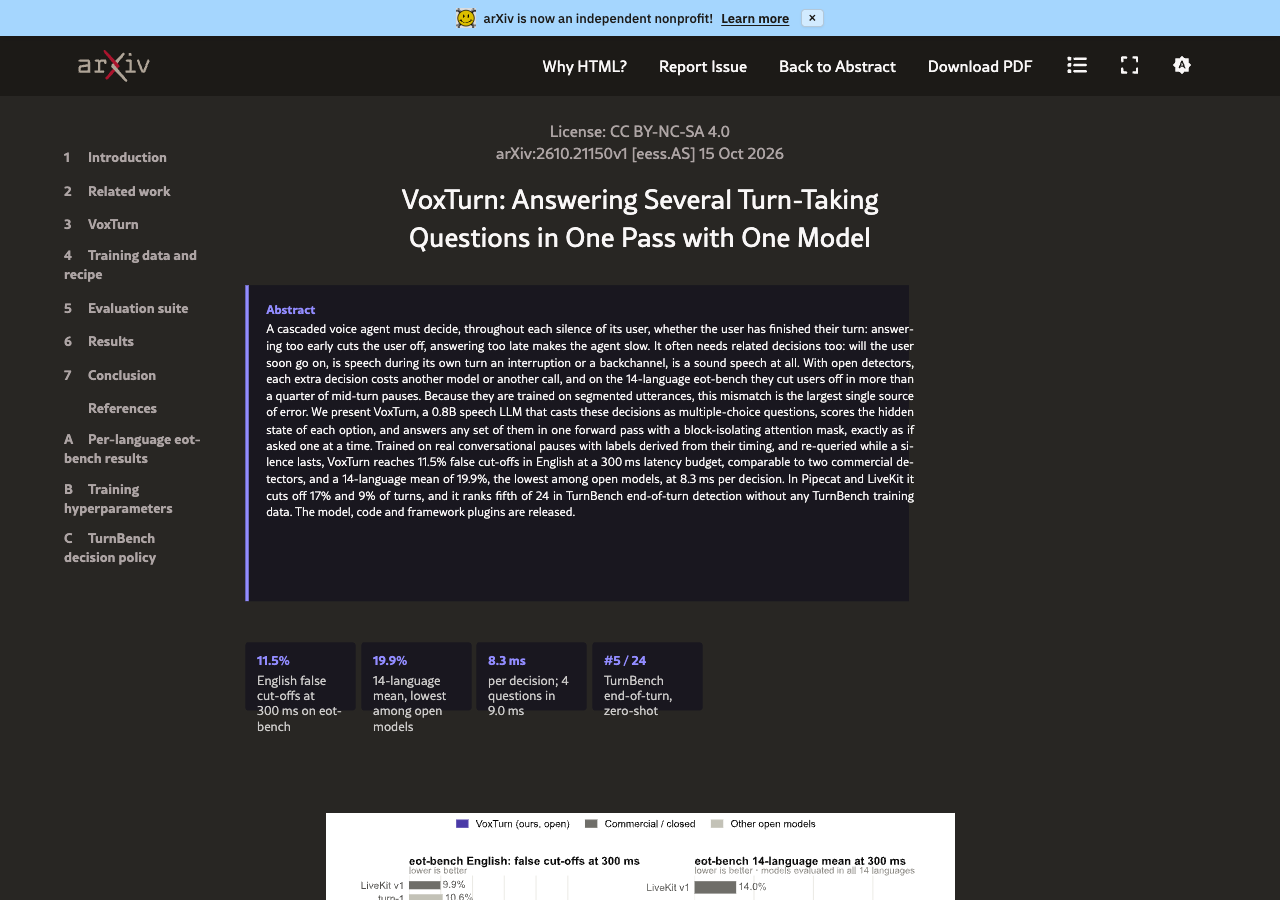
VoxTurn:音声エージェントの発話終了と割り込みを一度に判断 ↗

VoxTurnは、音声エージェントの会話の順番を判定する公開モデル。ユーザーの発話が終わったか、割り込みか相づちかを一度の推論で見分ける。著者らのeot-bench評価では、発話末尾の無音開始から平均300msで判定する条件で、途中の無音を発話終了と誤る割合は14言語平均19.9%だった。比較対象のLiveKit v1-miniは同条件で28.4%。この300msは音声アプリ全体の応答時間ではない。重みとコードは非商用のCC BY-NC 4.0で公開されている。

VoxTurn:音声エージェントの発話終了と割り込みを一度に判断:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
03Google Research2026-10-16研究段階

Google Research:実験結果から分子設計を修正するウェットラボAI ↗

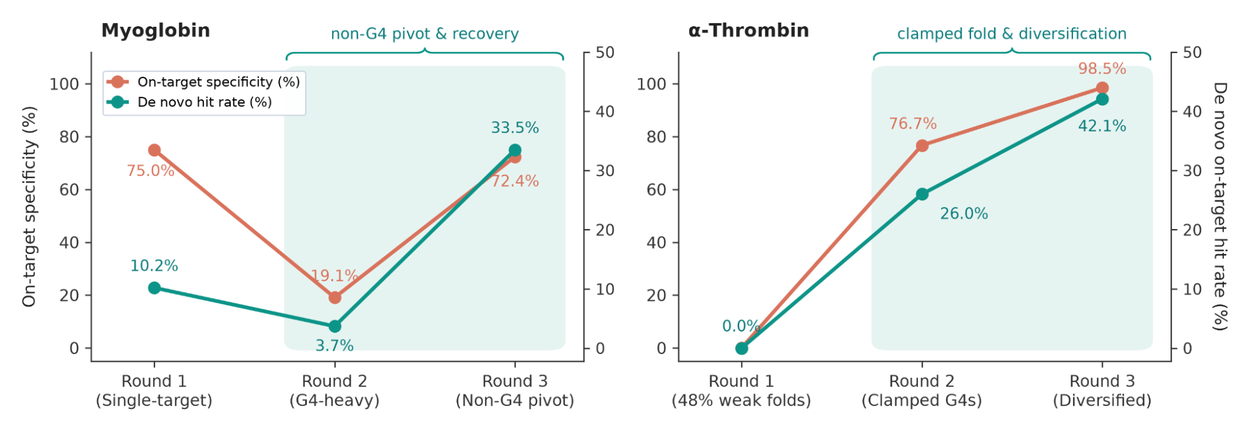
Google Researchが発表したのは、実験結果に応じて分子設計を更新するウェットラボ向けAIエージェントの研究群。タンパク質に結合するDNA候補を設計し、合成・選別・配列測定の結果を次の設計に反映した。Googleの3巡の実験では、新規設計DNA候補の標的への結合ヒット率がミオグロビンで10.2%から33.5%、αトロンビンで0%から42.1%になった。別のVERID基盤は、ロボット操作を実機投入前に3D状態と模擬実行で検査する。設計配列は人が承認し、実験も人が監督する。

ミオグロビンとαトロンビンの3ラウンドで、新規設計DNA候補の結合ヒット率と標的特異性の変化を示す折れ線図
Google Researchの原図。各標的の3ラウンドにおける新規設計DNA候補の結合ヒット率と標的特異性を示す。
04Ai22026-10-14要セットアップ

HiRO-ACEv2:強風・気圧も扱う高解像度気候シミュレーション ↗

HiRO-ACEv2は、全球3km解像度の気候データを生成する研究用AIモデル群。ACEが生成した約100km解像度のデータをHiROv2が細かくし、降雨・風・気圧を出力する。Ai2によるHiROv2の評価では、粗くしたX-SHiELDデータを入力すると、まれな極端値を含む高解像度統計が元のシミュレーションと3%以内の差に収まった。全球3kmデータを生成する全システムの費用は、X-SHiELDの約300分の1とAi2は報告する。現時点ではX-SHiELDに合わせたACE版と組み合わせる必要があり、ERA5などの過去データや将来の温暖化条件は扱えない。モデル重みと実行用ノートブックは公開されている。

HiRO-ACEv2:強風・気圧も扱う高解像度気候シミュレーション:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。
05清華大学・ByteDanceほか2026-10-15研究段階

ELLSA 2:発話中も聞き役の間も表情と身振りを生成 ↗

ELLSA 2は、音声とアバターの表情・身振りを生成するフルデュプレックス対話モデル。相手が話している間も、うなずきなどの動作を連続して生成する。会話に合う身振りを使うかの判断と、その動作の生成を分けている。著者らの67件の対話クリップでは、話し手・聞き手をまたぐ身振りの人手評価(Duplex、5点満点)がELLSA 2は3.201、MIBURIは1.858だった。単独の身振り・表情生成器のコードと重みは公開済みだが、統合ELLSA 2の重み公開は確認できない。

ELLSA 2:発話中も聞き役の間も表情と身振りを生成:原記事の冒頭画面
原記事の冒頭画面(スクリーンショット)。

確認範囲と不足

保存済み候補93件の見出し・抜粋と優先度の高い26グループを調べ、5件を収録した。収録記事には原図1件と原記事冒頭のスクリーンショット4件が保存されている。

93件は検討した候補の数であり、全件の本文を精査した数ではない。性能値は各発表元の評価条件で得られた結果である。

掲載しなかった候補 92件採点済みと未採点を分けて確認