Mellum2.1:コードの修正と確認を行う公開LLM ↗
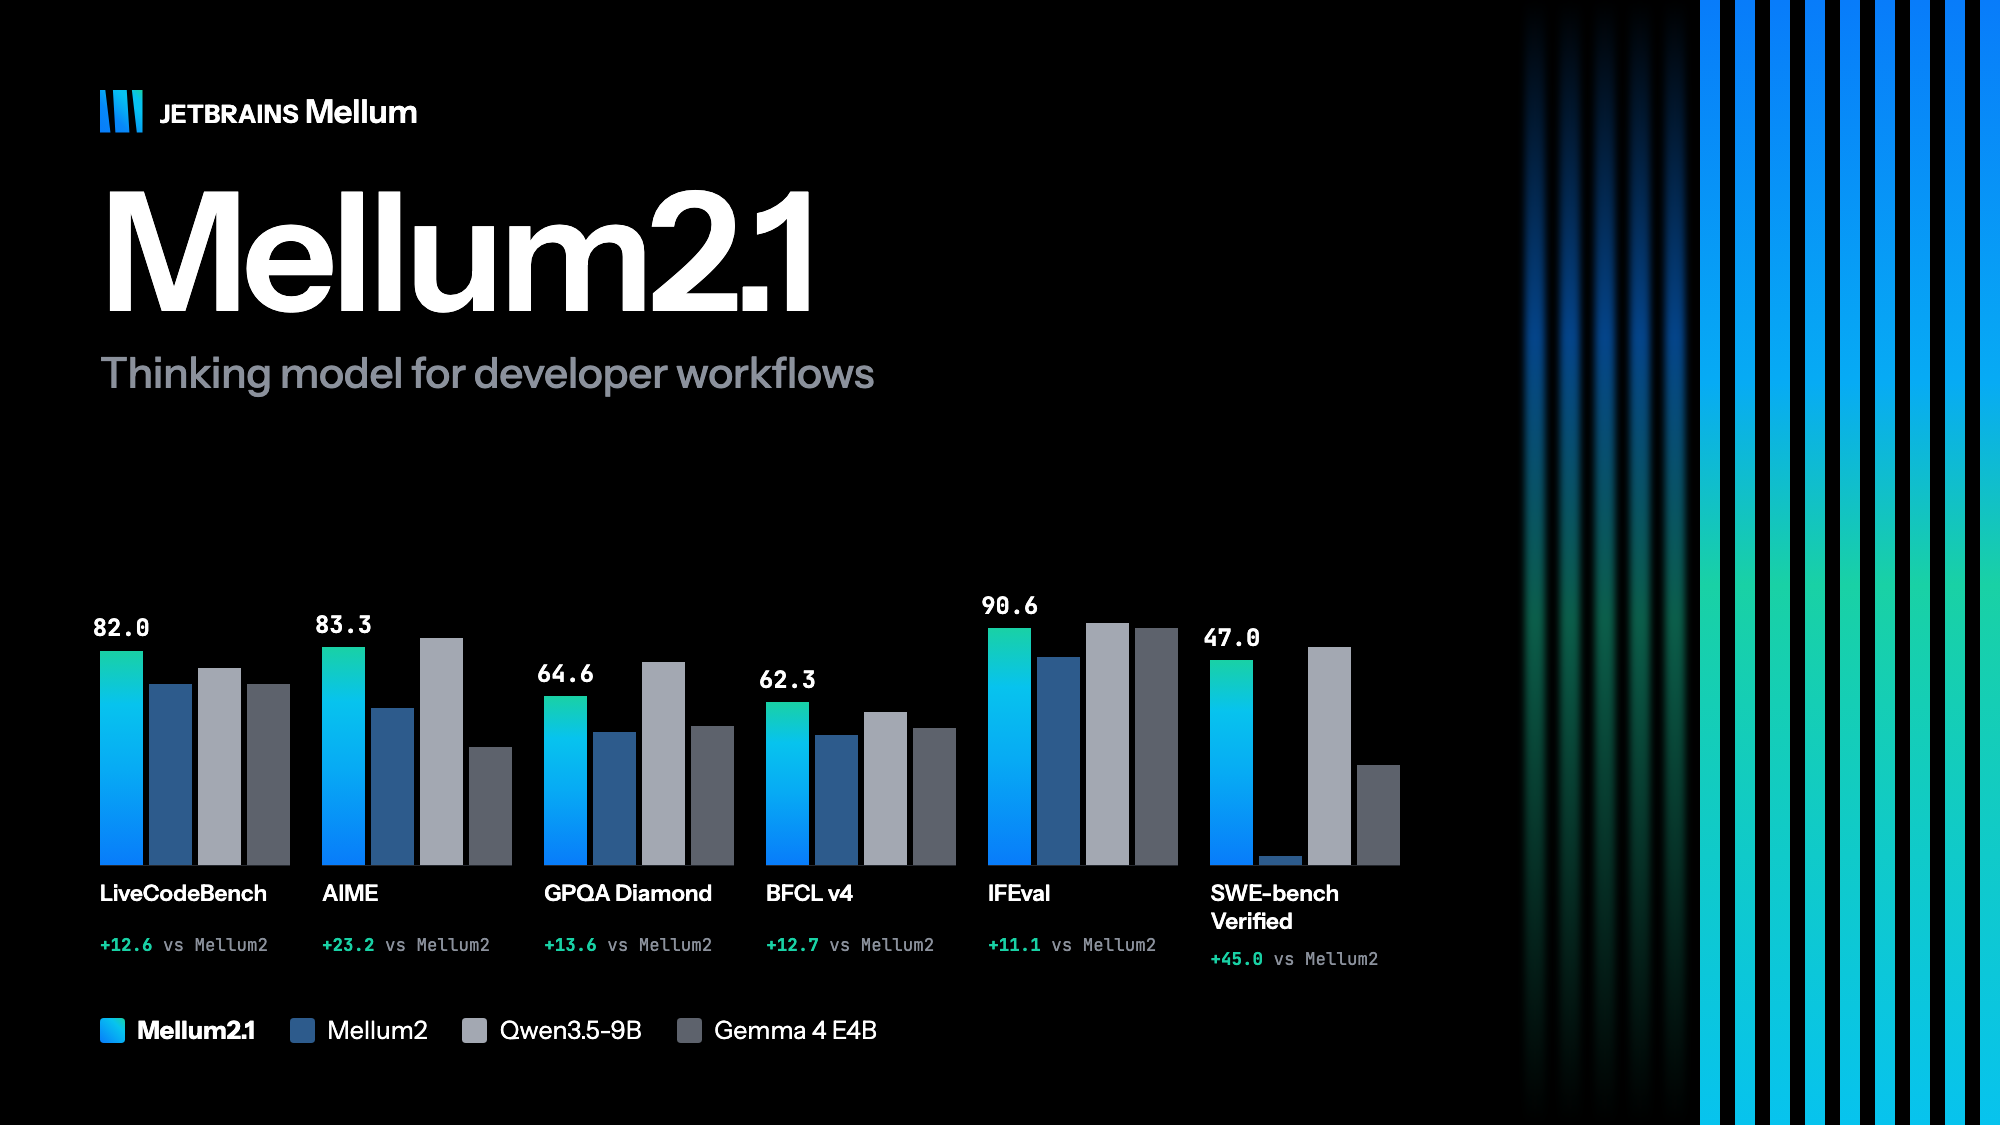
Mellum2.1は、コード修正エージェント向けの公開重みLLM。コードベースを調べ、ファイルを編集し、変更内容を確認する作業を、実際の開発環境での強化学習によって学んだ。JetBrainsの高負荷測定では、出力スループットがQwen3.5-9Bの約2倍。重みはApache 2.0で公開され、自前のエージェントへ組み込める。
Mellum2.1のコード修正、LightOnOCR-3の文書解析、画像も扱う検索モデル、多言語STT、映像履歴を使うロボット制御と、GPT-6.1 SolのUltrafast対応の計6話題を紹介する。
今回の調整:候補の選定では、新しい能力を持つモデルと具体的な実装を優先した。小幅な品質更新、局所的な推論最適化、機能差の小さい接続サービスは優先度を下げた。
Mellum2.1は、コード修正エージェント向けの公開重みLLM。コードベースを調べ、ファイルを編集し、変更内容を確認する作業を、実際の開発環境での強化学習によって学んだ。JetBrainsの高負荷測定では、出力スループットがQwen3.5-9Bの約2倍。重みはApache 2.0で公開され、自前のエージェントへ組み込める。
LightOnOCR-3は、レイアウトも抽出するOCRモデル群。文書画像から文章を読み取り、領域の種類と座標、画像の説明、グラフから読み取った数値の表も出力する。LightOnのH100 1基・512ページの評価では、各モデルの評価用設定で4B版はChandra-OCR-2より1ページの処理が19%速く、毎秒の処理ページ数が21%多かった。0.8B・1B・4Bの重みと変換用コードをApache 2.0で公開。
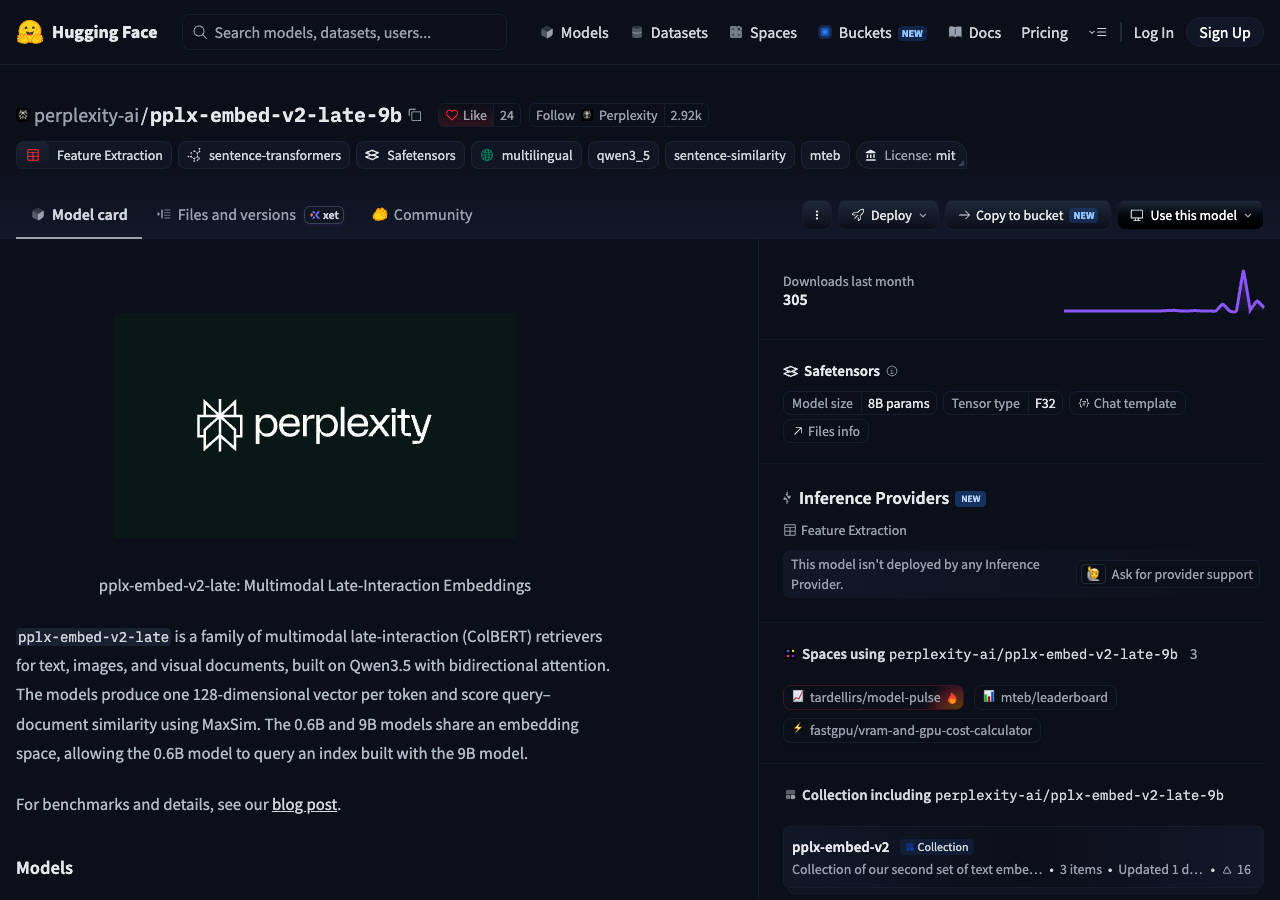
pplx-embed-v2-lateは、文章と画像の検索向け埋め込みモデル群。文章やPDFページの画像を検索対象にでき、関連度はトークンごとのベクトルを照合して求める。0.6B版と9B版が共通の埋め込み空間を使い、9B版で作った索引を0.6B版で検索できる。重みはMITライセンスで公開され、ローカル実装から利用可能。
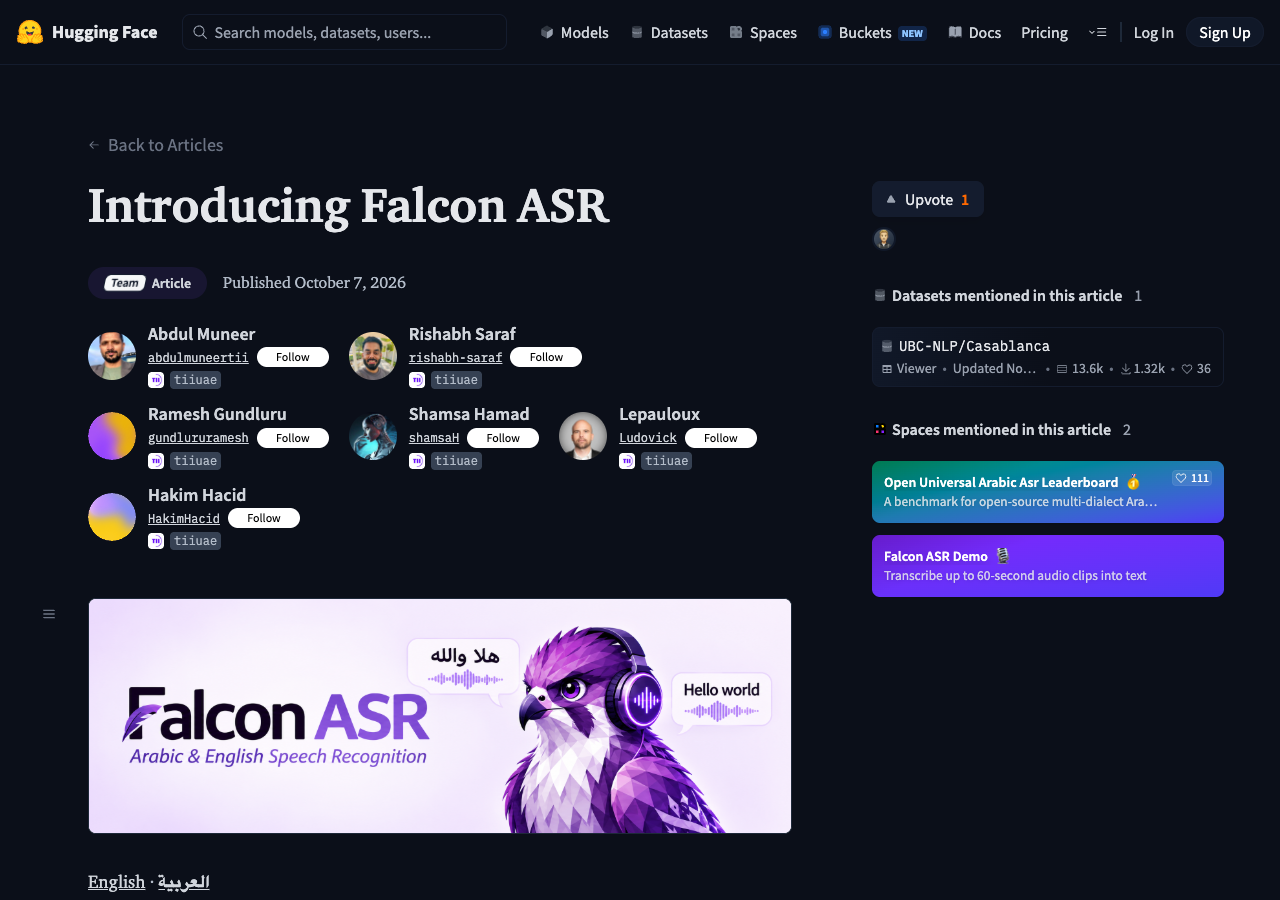
Falcon ASRは、アラビア語方言に重点を置く多言語STTモデル。英語など5言語を同じ重みで認識し、言語を事前指定せずに単語の時刻付き文字起こしを返す。TIIの評価では、英語の公開7テストセットで平均単語誤り率5.74%、アラビア語の6セットでは20.92%。Webデモを提供しており、API提供は今後の予定。
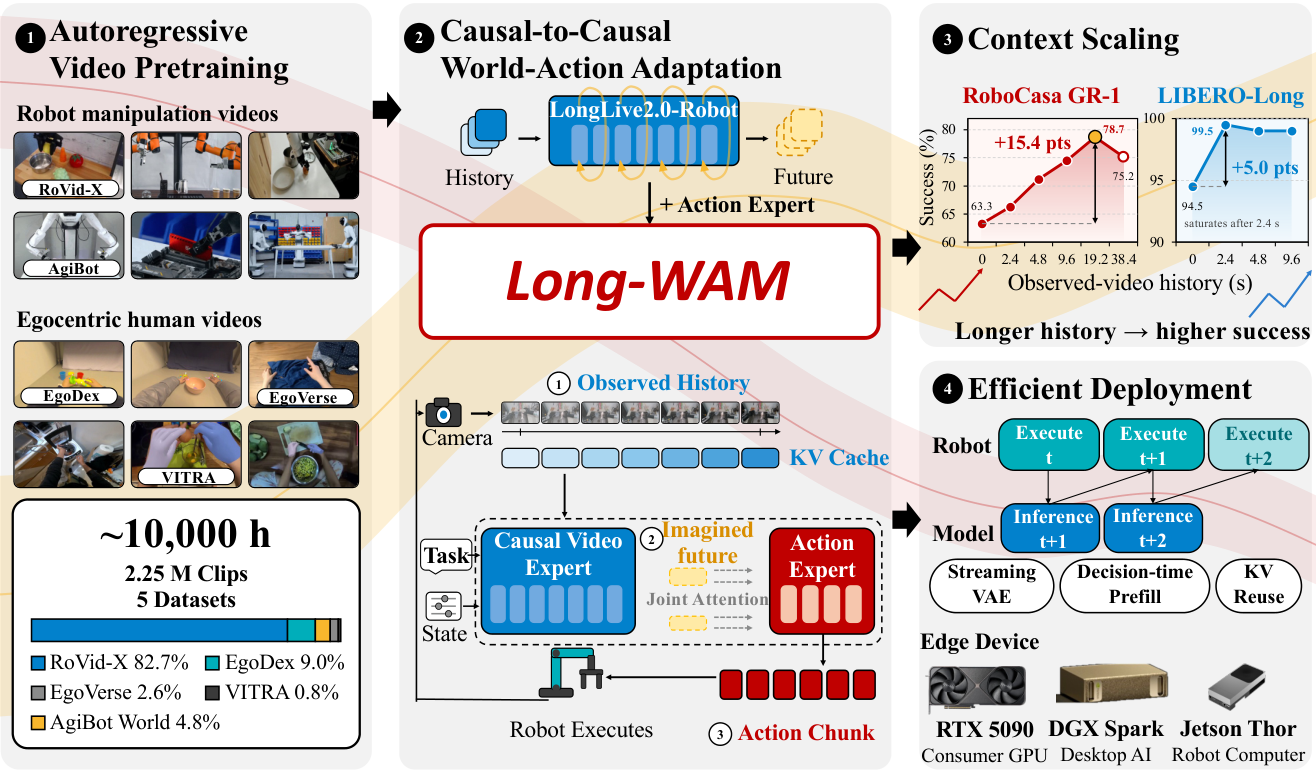
Long-WAMは、映像の履歴を使うロボット制御モデル。観測映像と指示からロボットの動作を生成する。過去の映像から次の映像を予測するよう事前学習し、その予測を動作の決定に使う。著者らのRoboCasa GR-1評価では、履歴なしのモデルで成功率63.3%、19.2秒の履歴を使うモデルで78.7%を記録。最適化した実行構成のRTX 5090測定では、未来映像の予測を含む1動作チャンクの推論時間が、2.4秒の履歴で107.4ms、19.2秒で341.0msだった。Unitree G1などで実機検証した研究。
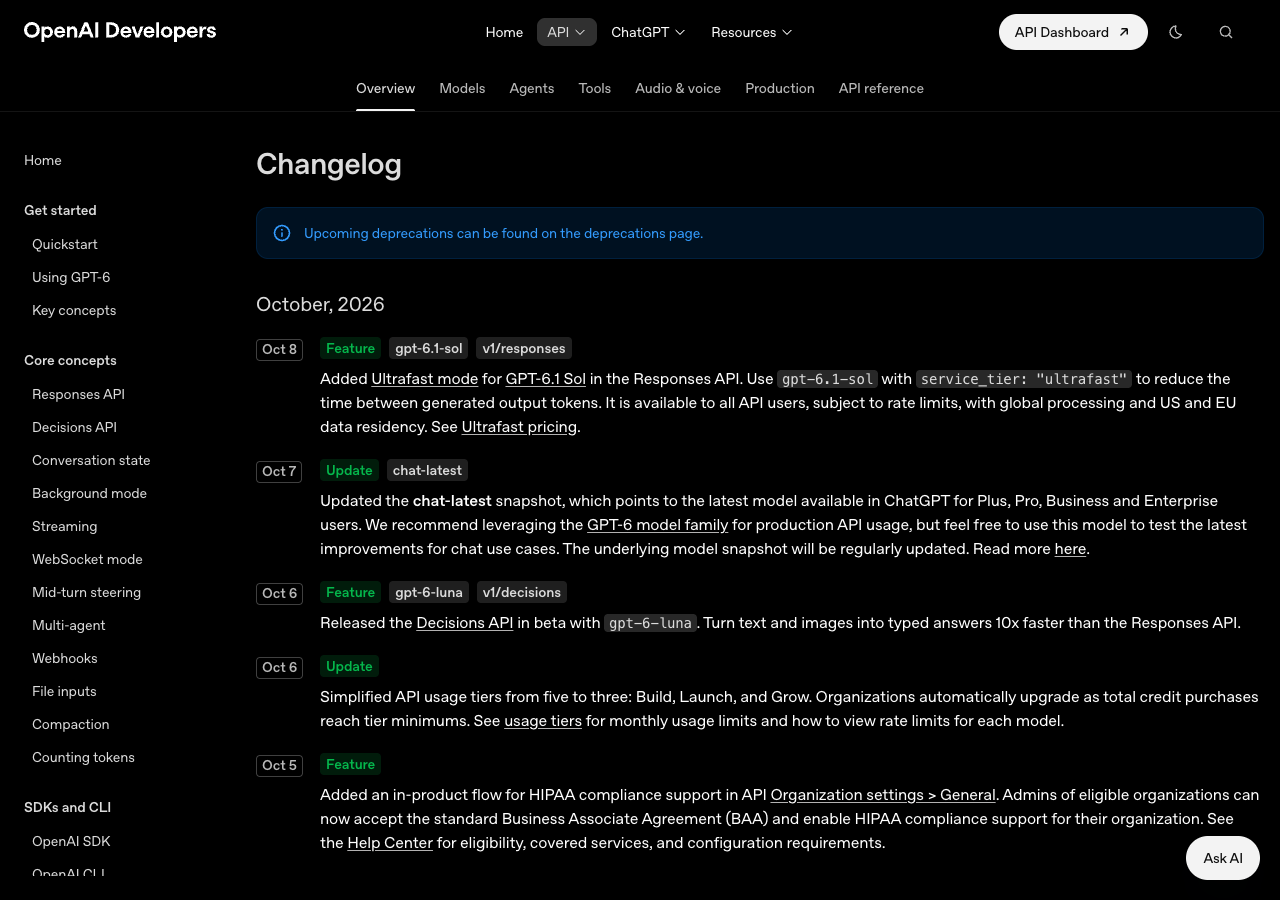
Ultrafastは、GPT-6.1 Solの出力トークン間隔を短縮する有料APIサービス枠。10月8日からResponses APIで選択可能になり、同じモデルの呼び出しで処理枠を切り替えられる。基本料金は100万トークン当たり入力12米ドル・出力60米ドルで、入力が272Kトークンを超えるとリクエスト全体に入力24米ドル・出力90米ドルの単価が適用される。
2026年10月9日号。10月4日〜9日を調査対象期間とし、前回号と24時間重なる10月7日以降の発表を優先した。RSS・GitHub APIで得た候補と、Web・検索の19情報源を調べ、公式本文と掲載履歴を照合して6話題を掲載対象に選んだ。調べた候補をすべて掲載したものではなく、全候補の本文を網羅した調査でもない。YouTube検索では対象期間の確認可能な動画候補を得られなかった。
TLDRは公開ページに接続できたが記事一覧を抽出できなかった。Perplexityの英語発表ページは取得できず、公式モデルカード、公式研究一覧の日付、取得できた翻訳版を照合した。性能値は提供元の測定で、独立した追試は行っていない。掲載画像は保存済みの原図2件と原記事のスクリーンショット3件。LightOnOCR-3は画像を取得できず、代替表示を置いている。