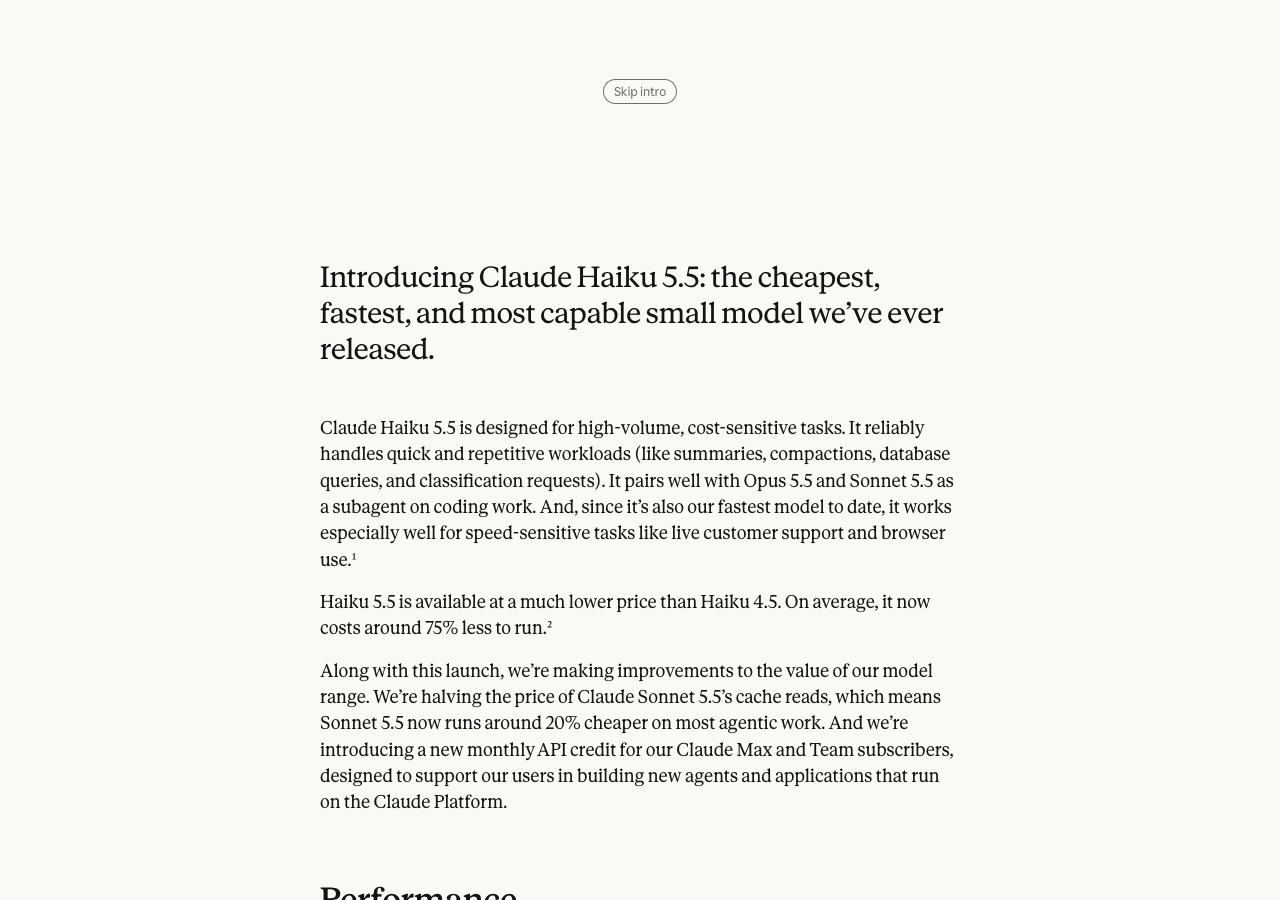
Claude Haiku 5.5:推論量を調整可能に、画面操作性能も向上 ↗
Claude Haiku 5.5は、大量の短い作業を低コストで処理する小型LLM。要約、分類、データベースへの問い合わせやコーディングの補助を担い、Haikuとして初めて推論量を調整できる。Anthropicの画面操作評価OSWorld 2.1のオフライン部分では、部分点を含むスコアがHaiku 4.5の15.7%から72.4%に向上。クラウドAPIで提供中。
小型LLM、マルチモーダル判断モデル、判断APIに加え、検索・音声応答の研究と生成メディアの識別ツールを紹介する全6件。
今回の調整:新モデルと判断APIの探索を優先し、小規模な推論最適化や単独ベンチマークは補助候補に回した。
Claude Haiku 5.5は、大量の短い作業を低コストで処理する小型LLM。要約、分類、データベースへの問い合わせやコーディングの補助を担い、Haikuとして初めて推論量を調整できる。Anthropicの画面操作評価OSWorld 2.1のオフライン部分では、部分点を含むスコアがHaiku 4.5の15.7%から72.4%に向上。クラウドAPIで提供中。
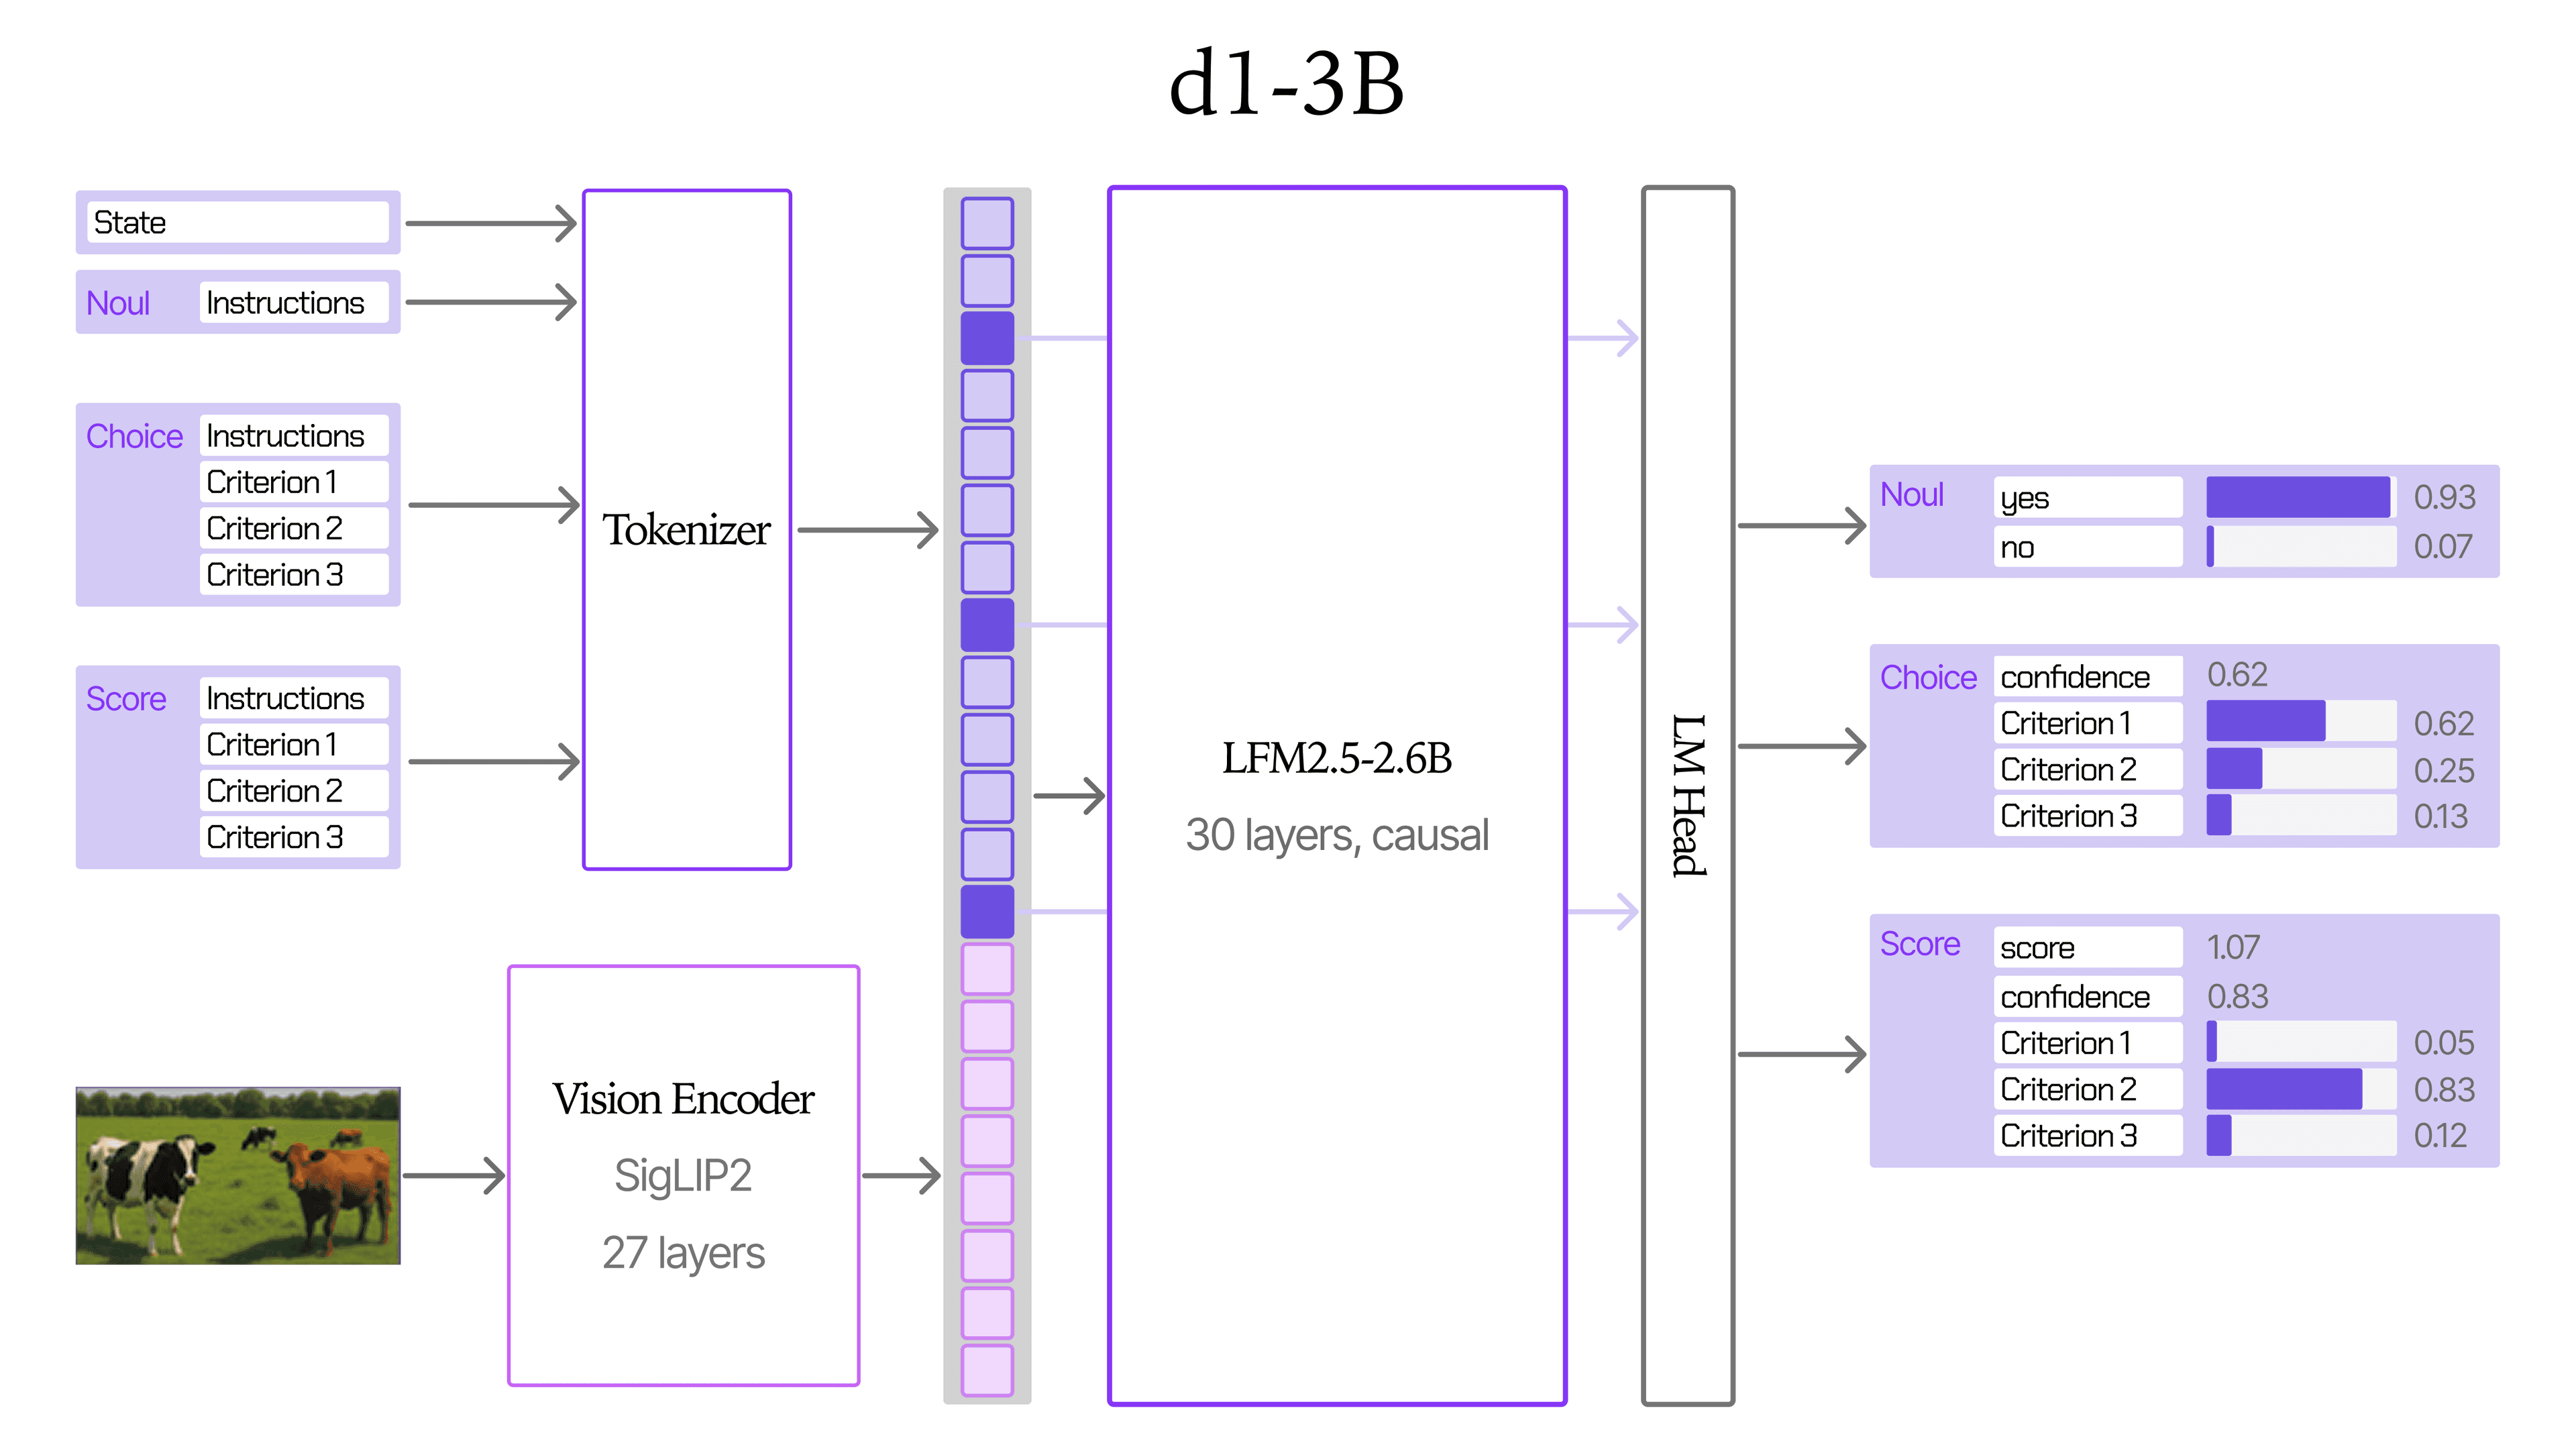
Open d1は、文章・画像・音声の判定に使う小型モデル群。文章を生成せず一度の推論で判断を返し、公式デモではカメラ映像からジェスチャーや不適切な内容を判定する。d1-3Bは文章と画像に対応し、実験版のd1-omni-600Mは文章に画像または音声を組み合わせて扱う。Liquid AIのd1-3B測定では、RTX 4090で1件ずつ処理した入力から出力までの遅延は、単一質問で8ms、384px画像で17ms。両モデルの重みを公開し、対応するllama.cppでローカル実行できる。
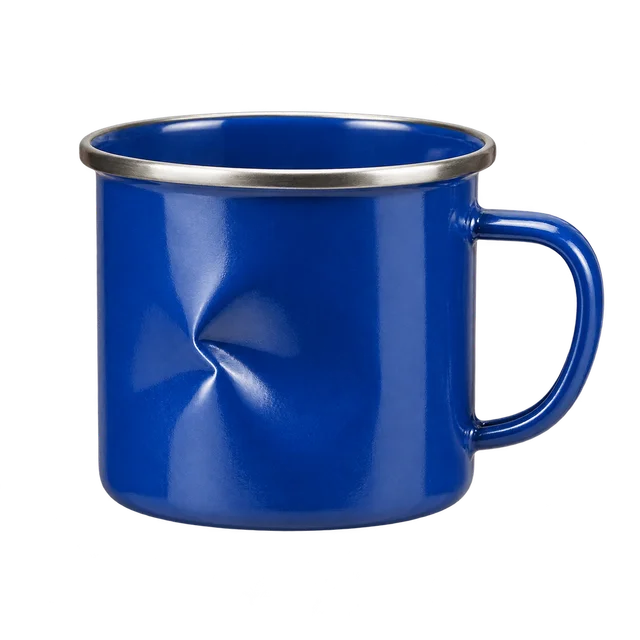
Decisions APIは、文章と画像の分類・採点に特化したGPT-6 LunaのAPI。条件が成立する確率、指定した選択肢、段階評価のスコアを返し、問い合わせの担当部署分けや写真の損傷判定に使える。OpenAIの公式ガイドはResponses API比で約10倍高速に結果を返すと説明しているが、詳しい測定条件は示していない。10月6日から公開ベータとして提供。
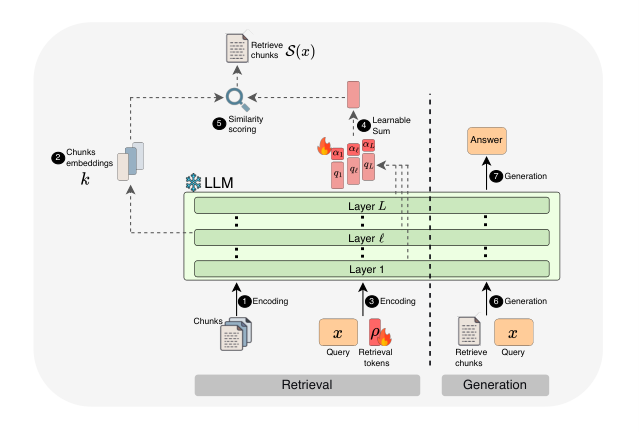
UNREALは、検索と回答生成を同じLLMで行う研究手法。長い文章や文書集合から質問に関係する箇所を選び、その本文を使って回答する。本体の重みを固定したまま検索用の少数のパラメータを学習し、LLM内部の表現で資料を照合する。著者らのHotpotQA評価では、同じNemotron-3.5-Lightningに検索上位5件を渡す条件で、回答F1がQwen3-Embedding-4Bとリランカーを使う場合の55.3から65.8に向上。
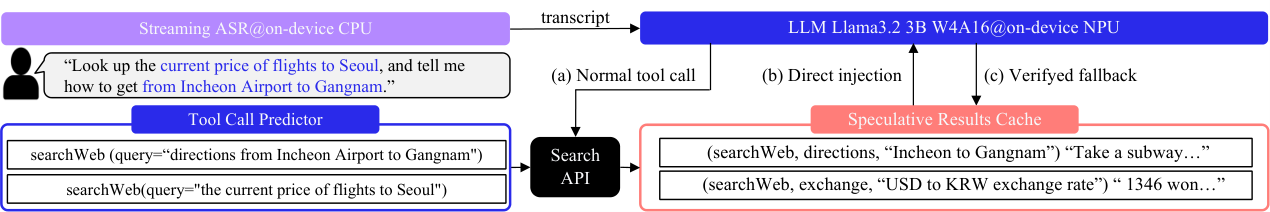
QualcommとKAISTの研究は、端末内の音声エージェントで検索待ちを短くする手法。ストリーミングSTTの途中結果から必要な検索を予測して先に実行し、発話の訂正を確認したうえで結果をLLMへ渡す。著者らのAndroid端末上の英語タスク評価では、発話終了から最初の音声応答までの中央値が、逐次実行の5.79秒から4.60秒に短縮。検索には外部APIを使い、先行実行は読み取り専用ツールに限る。
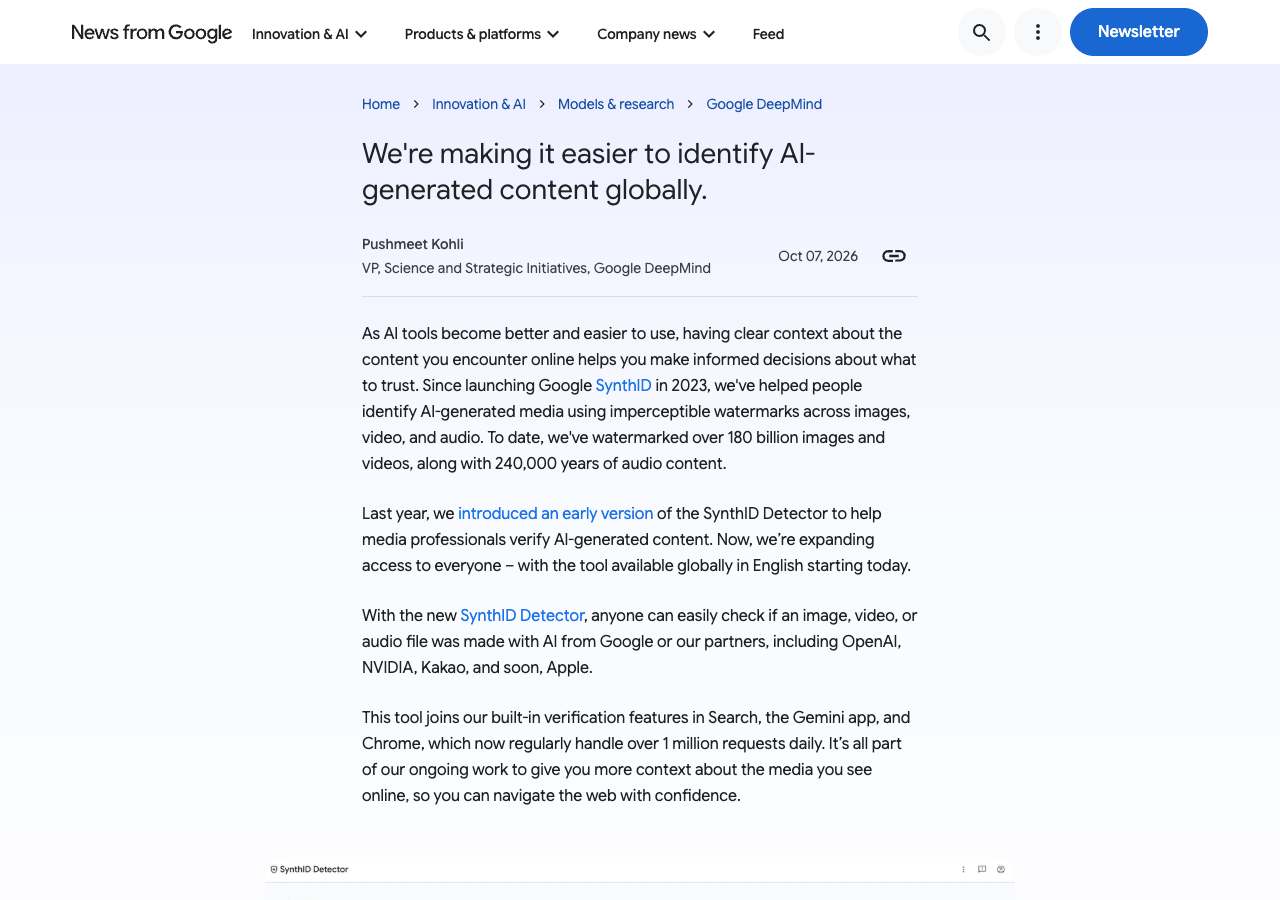
SynthID Detectorは、AI生成メディアに埋め込まれたSynthIDの透かしを調べるWebツール。画像・動画・音声を渡すと、Googleや対応パートナーのAIで生成された内容かを確認できる。10月7日にメディア関係者向けの提供から、英語で世界中の一般利用者へ公開を拡大。透かしのないAI生成物まで見分ける汎用判定器ではない。
2026年10月3日〜8日を対象に、前号との重複期間を含む10月6日以降を優先。収集済みRSS・GitHub API候補と、設定された19件のWeb・検索先を調べた。収集時に本文または取得可否を確認した資料は参考資料を含め18件で、掲載は原発表・原論文に基づく6件。発見した全候補を精査したわけではない。既掲載のMistral Large 4、EmbeddingGemma 2、vLLM更新などは再掲載していない。
収集時のYouTube検索では対象期間の確認可能な動画が見つからず、動画・字幕は参照していない。採用外候補ではMarkTechPostが403、Nature論文は取得に失敗した。画像は原図と原記事のスクリーンショットを使用。SynthIDは原図の代わりに原記事のスクリーンショットを使用。Haikuは導入画面の下にある記事本文をスクリーンショットで掲載。性能値は提供元・論文著者の報告で、独立した再測定は行っていない。