SIGNAL2026-10-03 · AI TECH REPORT

Clefの画像判断、Microsoftの逐次音声認識、AstaBriefの研究レポート生成

画像や文章を選択肢へ分類するモデル、話している途中から文字起こしする音声モデル、引用付き研究レポートを生成する小型モデルを紹介する。ローカル推論基盤の判断モデル対応と合わせて4話題を取り上げる。

今回の調整:新モデルの能力・利用条件と判断モデル・音声モデルの実装を優先し、汎用チャット機能や企業の導入・提携だけの話題を検索の中心から外した。

01Cloudflare2026-10-01API利用

Clef:画像と文章から、選択肢ごとの確率を返す判断モデル ↗

Cloudflareが判断モデルのClefとClef-flashを公開した。文章を生成する代わりに、入力を一度処理して指定された選択肢を並列に採点し、確率を返す。公式例では問い合わせの緊急度や担当部署を分類しており、画像入力と64Kトークンの文脈長にも対応する。基盤モデルはそれぞれQwen3.8-27BとQwen3.5-9B。提供元によるBANKING77の分類評価では、macro-F1がClefで94.20、Jevで79.74だったが、比較時の実行環境や詳細条件は不明。Workers AIではアプリからクラウドへ入力を送るAPIとして利用でき、呼び出しにはCloudflareのアカウントIDと認証トークンが必要となる。モデルの重みはApache 2.0で公開されている。ローカル利用では、Ollama 0.35.1が両モデルと画像付きの /v1/systemone 呼び出しに対応する。Ollamaの更新に加えてモデルの取得が必要で、必要メモリと日本語精度は未確認。
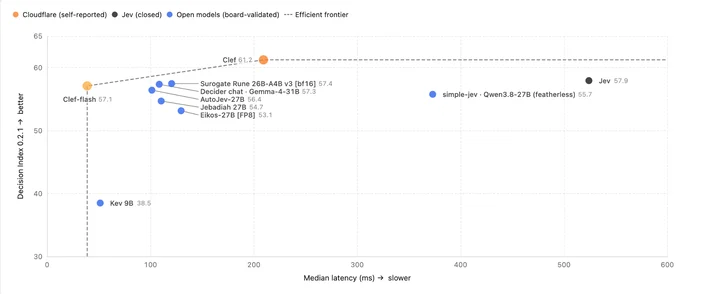
判断性能(縦軸)と応答時間(横軸)の比較。Cloudflare提供。
02Microsoft AI2026-10-01実験版

Microsoftの新音声モデル:発話途中の文字起こしと、言語を切り替えても保たれる声 ↗

Microsoftが文字起こしモデルのMAI-Transcribe-2-Streamingと、音声生成モデルのMAI-Voice-2.1、MAI-Voice-2.1-Flashを発表した。文字起こしは60言語を対象に使用言語を継続的に検出し、発話途中の暫定結果を後続の音声に応じて修正してから確定する。音声生成の2モデルは23言語・26ロケールに対応し、公式記事では英語から中国語、ドイツ語へ切り替えても同じ話者の声を保つ例を紹介している。参照音声から声を複製する機能には同意確認の仕組みがあり、利用には申請・承認と同意音声の提出が必要。いずれもMicrosoft Foundryなどから呼び出すクラウドサービスで、Azureではパブリックプレビューとして提供され、SLAの保証はなく本番利用は推奨されていない。Azure経由の利用にはAzureサブスクリプションと対応地域のFoundry/Speechリソースが必要で、公式のSpeech SDK利用例ではリソースのキーで認証する。文字起こしのSDK手順はAzure Speech SDK 1.52.0を前提とする。発表時の料金は、文字起こしが2026年末まで音声1時間当たり0.54ドル、音声生成が100万文字当たり通常版22ドル、Flash版15ドル。Microsoftは商用利用のライセンス権を保有すると説明しているが、生成・複製音声の用途別の商用利用条件は未確認。日本語の対応詳細・精度と、音声生成に必要なSDK版も未確認。

Microsoft公式記事の冒頭画面(スクリーンショット)。
03Ai22026-10-02Webで利用

AstaBrief 8B:検索済みの論文を、一度の生成で引用付きレポートへ ↗

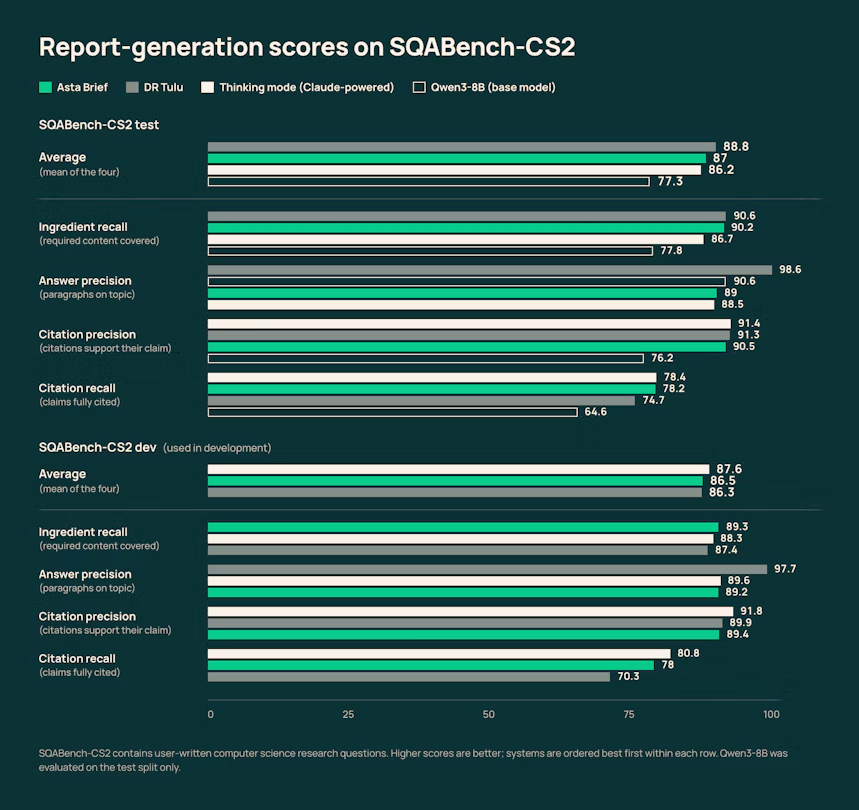
Ai2がQwen3-8Bを追加学習したAstaBrief 8Bを公開した。研究上の質問と検索済みの論文抜粋を受け取り、章ごとに分けて生成せず、引用付きレポート全体を一度に書くモデルだ。AstaのFast modeで利用でき、モデルの重みもApache 2.0で配布されている。手元のPDFを使ってレポートを作る公式ワークフロー例も公開された。提供元によるAstaの処理全体の比較では、レポート1件当たりの平均所要時間がFast modeで51.1秒、Claudeを使うThinking modeで178.5秒となり、約3.5倍の速度だった。これは処理手順の変更も含む比較で、トークン生成だけの速度差を示すものではない。主な評価は2025年に実施され、測定ハードウェアと比較時のClaudeの厳密な版は不明。ローカル利用には論文の検索処理とモデルの推論環境を別途準備する必要があり、最低メモリ・必要なライブラリ版・日本語性能は未確認。併せて公開されたDPO学習用データは英語6,622件で、CC BY-NC 4.0の非商用条件があり、モデルとはライセンスが異なる。

レポート品質・引用精度を比べた公式評価図。Ai2提供。
04ggml-org2026-10-02要セットアップ

llama.cpp:ローカルAPIで判断モデルを呼び、文書の種類や処理先を分類 ↗

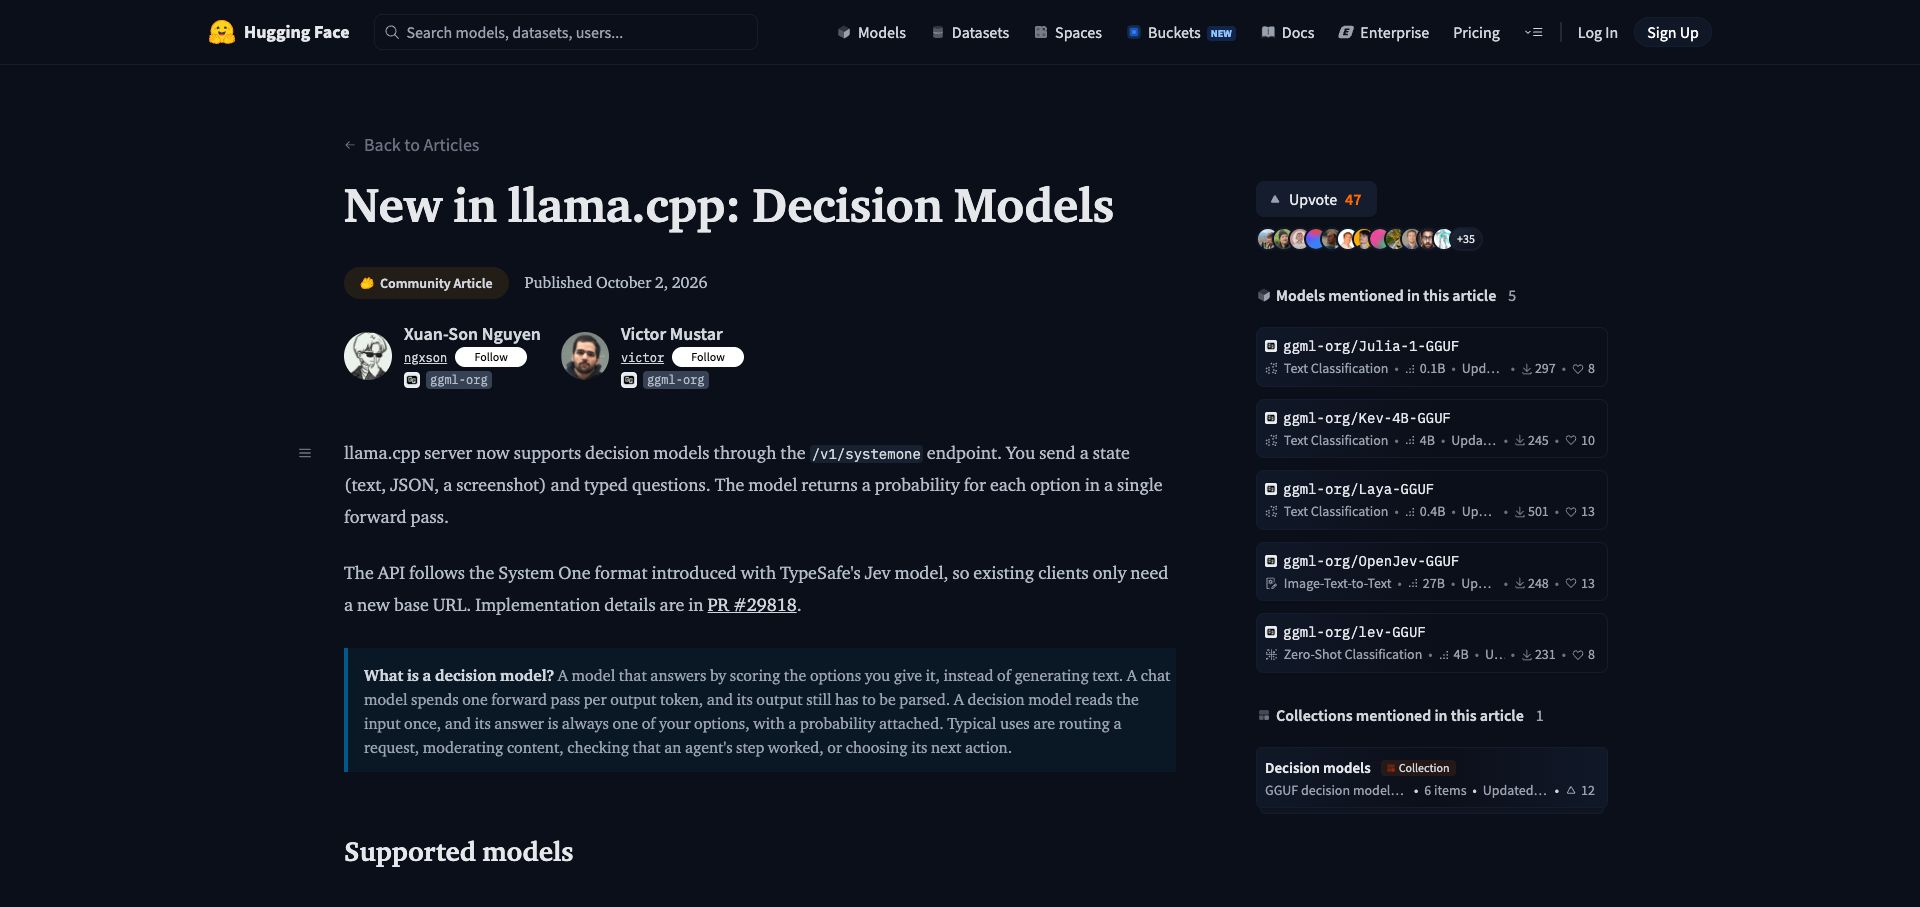
llama.cppの開発元が、判断モデルを呼び出す /v1/systemone APIへの対応を公開した。ローカルサーバーへ文章や画像と、回答形式を指定した質問を送ると、選択肢ごとの確率、段階評価、真偽に関する確率を受け取れる。公式例では、二重請求についての問い合わせを担当部署へ振り分けたり、文書画像を請求書・領収書・契約書などに分類したりしている。利用には最新のllama.cppと対応するGGUF形式のモデルが必要で、最低限必要なビルド番号は記事に明記されていない。Kev-4Bなどは文章用で、画像対応の例として挙げられているのはOpenJev 27B。OpenJevは日本語を対応言語に含むが、ライセンスはCC BY-NC 4.0で非商用条件があり、Apache 2.0の他の掲載モデルとは利用条件が異なる。画像をAPIへ渡して分類する機能であり、画面操作を行うものではない。必要メモリと環境別の動作は未確認で、記事時点ではClefへの対応は今後の予定となっている。

llama.cpp公式解説の冒頭画面(スクリーンショット)。

確認範囲と不足

2026年10月3日号。前回掲載日の10月2日に24時間の重複を取り、10月1〜3日を重点確認。設定された19収集先すべてにライブ検索または公開一覧の取得を実施した。OpenAI、Anthropic、Google AI、Hugging Face、The Decoder、TLDR AI、AlphaSignal、InfoQ、Hugging Face Daily Papersは公開一覧と候補の出典リンクを確認。Medium AI、Qiita、Simon Willisonも一覧を確認した。Medium LLMは一覧取得が失敗し、Zennは一覧から記事が抽出されず、渡された候補と検索で補完。Ollamaは個別リリース本文を確認し、一覧との表示差を解消。llama.cppは一覧で入力の最新タグを再確認できず、開発元の新着解説を確認した。vLLMの表示上の最新は9月22日、AINewsの最新表示は9月9日で、対象期間の新着として扱わなかった。YouTubeは複数の検索で検証可能な対象動画を確認できなかった。原記事・配布カード等15件を確認し、うち論文関連2ページは要旨まで。保存本文が未取得だった関連2件も含め、判断記録は17件。4つの独立した話題を選定した。

全サイトの全記事を網羅した調査ではない。私的アーカイブの意味検索は名前解決エラーで失敗し、コマンドが返した本文検索結果と掲載履歴で照合したため、意味だけが近い重複を取りこぼす可能性がある。性能値は提供元の報告で、実機追試は未実施。YouTubeの動画・字幕は未確認。画像には原記事の掲載図と、記事冒頭のスクリーンショットを使用。